同樣叫 AI,有的寫文章,有的只回一串數字
AI 模型最實用的分類方式,是看它吃進什麼、吐出什麼。
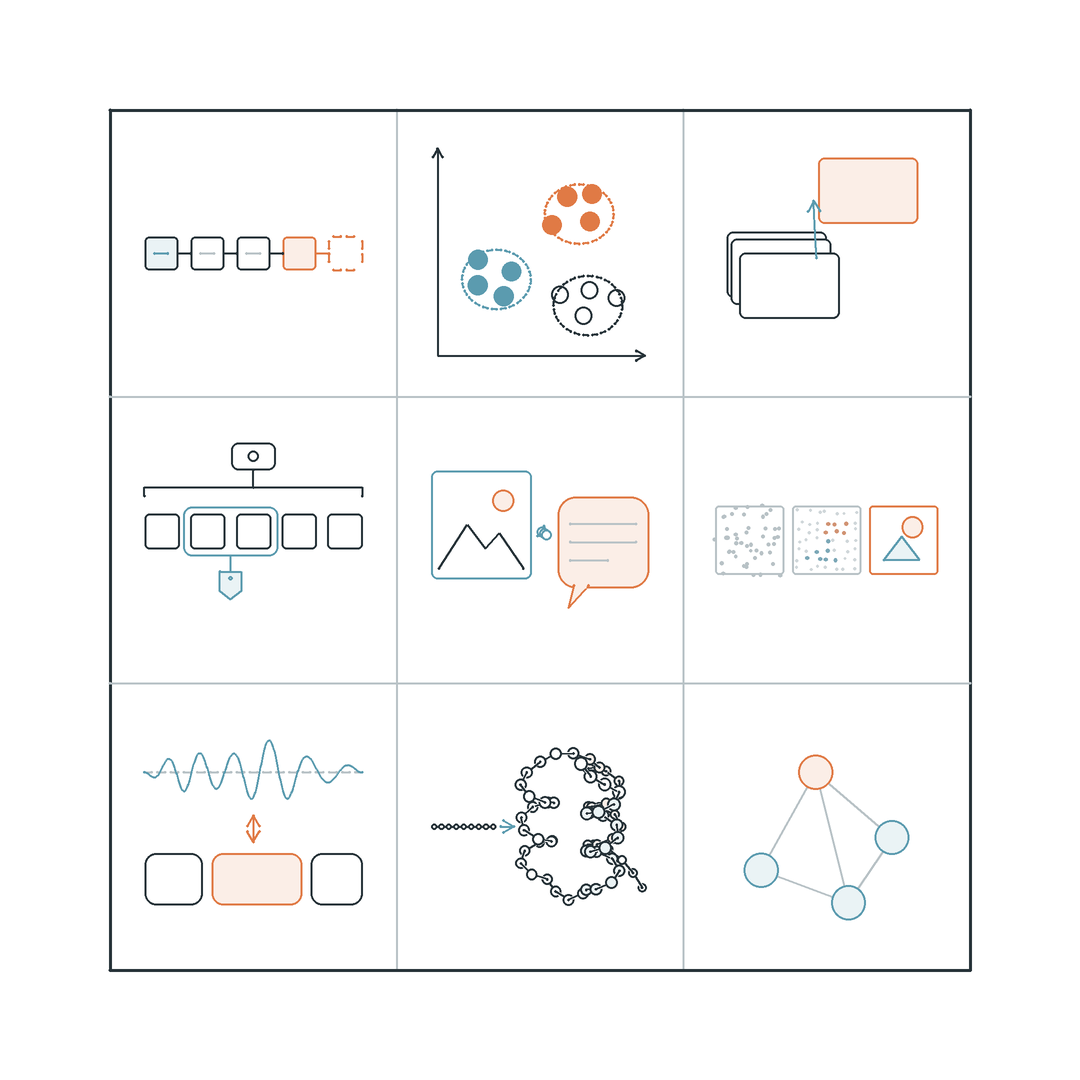
搜尋引擎替你找到想看的文章,手機替影片自動上字幕,相簿認出哪幾張照片裡有貓。這些功能背後的模型,你知道有幾個會跟你聊天嗎?很少。它們有的輸出一段文字,有的只輸出一個分數、一個標籤或一串數字座標。這篇文章把常見的九類模型排成一張地圖,就像看地圖先找起點和終點,每一類都寫清楚輸入與輸出,再說它適合做什麼、什麼時候該換別的。
九類模型各有一篇短文細談,連結放在各段末的延伸閱讀。
大型語言模型:文字進、文字出
大型語言模型(LLM)讀進一段文字,再逐字往下接,寫出一段新的文字。
它的訓練目標很單純,就是根據前文預測下一個字詞片段。現在主流的架構叫 Transformer,靠「注意力」機制決定每個字要參考前文的哪些部分。模型夠大、讀過的文字夠多之後,只要在提示裡給幾個例子,它就能翻譯、摘要、改寫或回答問題。推理模型是大型語言模型的一個分支,會在給答案前先寫出一長串中間步驟。數學題和多步驟規劃因此更穩,代價是更慢、用掉更多運算。你需要的是一段新寫的文字時,才輪到它。
延伸閱讀:大型語言模型怎麼運作:一次預測一個 token,接出整段回答
決策模型:替列好的選項打分數
決策模型讀進一個情境和一組事先列好的選項,直接替每個選項給出機率。
它不寫文字,所以輸出不必再解析,也不會冒出選項以外的答案。適合的工作像「這篇摘要屬於哪一類研究」「這封信要轉給哪個部門」,選項固定,你只想知道哪個最可能。本站已有一個系列專門介紹,五篇都收在AI 從原理到實戰系列。入門可從決策模型是什麼讀起,原理見決策模型的原理與訓練。
嵌入模型:把內容變成地圖上的座標
嵌入模型把一段文字或一張圖轉成一串固定長度的數字,也就是一個向量。
向量就像一張高維度地圖上的座標,意思相近的句子,座標就靠得近。Sentence-BERT 這類模型讓句子的相似度能直接用距離計算。CLIP 則把圖片和文字放進同一張地圖,所以一句話就能找出對應的照片。常見用途有語意搜尋、把堆積的大量文件分群、找出重複內容,還有 RAG(檢索增強生成)的第一步。這一步先從資料庫撈出可能相關的段落,再交給大型語言模型作答。嵌入模型本身不寫任何文字。
重排序模型:把撈回來的候選重新排名
重排序模型(reranker)把問題和一段候選文字一起讀,給出這段文字有多相關的分數。
嵌入模型把問題和文件各自轉成座標再比距離,速度快,但兩邊從頭到尾沒有放在一起讀過。重排序模型屬於交叉編碼器(cross-encoder),會同時讀問題和候選內容,所以判斷通常比較準。為什麼不把全部文件都交給它?因為每一組都要重新計算,所以實務上常分兩段:先用嵌入模型或關鍵字搜尋撈回一批候選,再由重排序模型挑出最前面幾筆。另一種做法是讓決策模型逐層挑資料,可參考本站的 DecisionRAG 介紹。
延伸閱讀:重排序模型:先撈回一百筆,再把真正回答問題的排到最前面
編碼器分類與序列標註:貼標籤、圈出名詞
編碼器分類模型讀完整段文字後輸出一個標籤,序列標註則替每個字詞各貼一個標籤。
代表是 BERT 這類編碼器。它同時看一個字的前文與後文,再接上一層小小的分類器,用你標好的例子微調。整句一個標籤的例子有垃圾信判斷、評論正負面、文件主題。每個字詞一個標籤的例子則是命名實體辨識(NER),從文字中圈出人名、藥名、基因名。這類模型通常比生成式模型小得多,所以跑得快、成本低,類別固定又有標註資料時很合用。限制在於類別要事先定好,訓練時沒出現過的類別,它就無從判斷。
延伸閱讀:編碼器分類與序列標註:替整段文字貼標籤,或替每個字圈出名詞
視覺語言模型:看圖之後用文字回答
視覺語言模型(VLM)同時讀進圖片和文字,輸出一段文字。
常見做法是先用影像編碼器把圖片切成小塊,轉成模型讀得懂的表示,再交給語言模型處理。LLaVA 就是把影像編碼器接上大型語言模型,再用圖文問答資料訓練。你可以請它描述照片、讀表格截圖,或回答「這張圖的 Y 軸是什麼」。它的輸出仍是文字,不會畫圖。遇到很小的字、密集的數字或專業影像,它可能看錯,所以重要數值最好回到原圖核對。
影像生成模型:從一段描述畫出圖片
影像生成模型讀進一段文字描述,輸出一張圖片,目前主流做法是擴散模型。
擴散模型訓練時學的是把一張加了雜訊的圖一步步還原。生成時就從一張純雜訊開始,依照文字描述反覆去除雜訊,畫面慢慢浮現。潛在擴散模型把這個過程搬到壓縮後的空間進行,運算量因此大幅降低,許多開源繪圖工具都建立在這個做法上。它適合做插圖、概念草圖與設計參考。不過畫得看起來合理,不代表符合事實,儀器構造、解剖位置和圖中的文字都需要人工確認。
延伸閱讀:影像生成模型怎麼畫圖:從一片雜訊擦出畫面,以及它不能當證據的原因
語音模型:把聲音轉成字,或把字念出來
語音模型主要分兩個方向:語音辨識(ASR)把聲音轉成文字,語音合成(TTS)把文字轉成聲音。
語音辨識模型讀進一段音訊,輸出逐字稿。Whisper 用大量網路上「音訊配字幕」的資料訓練,能處理多種語言與口音,常用在會議記錄和影片字幕。語音合成走反方向:Tacotron 2 這類系統先由文字算出聲音的頻譜,再交給另一個模型轉成實際的波形。有些新產品把聽、想、說串成一條流程,裡面通常仍包含這兩類模型。辨識最容易出錯的地方,是專有名詞、口音重的段落,以及雜音吃掉字音的吵雜環境。
延伸閱讀:語音模型怎麼運作:語音辨識把聲音轉成字,語音合成把字念出來
生物序列與結構模型:讀蛋白質與 DNA 的序列
生物序列模型把蛋白質的胺基酸序列或 DNA 鹼基序列當成一種文字來讀,輸出預測的結構或功能。
蛋白質語言模型(例如 ESM-2)讀過大量已知蛋白質序列,學到哪些胺基酸組合常一起出現。研究團隊再用它從單一序列預測立體結構。AlphaFold 則專門預測蛋白質會折成什麼形狀。DNA 模型讀的是基因體序列,用來預測某段 DNA 或某個變異會怎麼影響基因調控。本站寫過的 AlphaGenome Atlas 就屬於這一類。它們給的是預測,能幫研究者決定先驗證哪幾個候選,但不能取代實驗。
延伸閱讀:生物序列與結構模型:把蛋白質和 DNA 當成文字來讀,預測結構與變異效應
九類模型一張表
把九類並排看,差別主要在輸出端。
| 類型 | 輸入 | 輸出 | 典型用途 |
|---|---|---|---|
| 大型語言模型 | 文字 | 文字 | 寫作、摘要、翻譯、問答 |
| 決策模型 | 情境+固定選項 | 每個選項的機率 | 分流、分類、選擇 |
| 嵌入模型 | 文字或圖片 | 向量 | 語意搜尋、分群、RAG 檢索 |
| 重排序模型 | 問題+候選內容 | 相關分數 | 檢索結果重新排名 |
| 編碼器分類 | 文字 | 標籤 | 垃圾信、情緒、命名實體 |
| 視覺語言模型 | 圖片+文字 | 文字 | 看圖問答、讀圖表 |
| 影像生成模型 | 文字 | 圖片 | 插圖、草圖 |
| 語音模型 | 聲音或文字 | 文字或聲音 | 字幕、朗讀 |
| 生物序列模型 | 胺基酸或 DNA 序列 | 結構或效應預測 | 結構預測、變異排序 |
怎麼選:先問輸入,再問你要什麼輸出
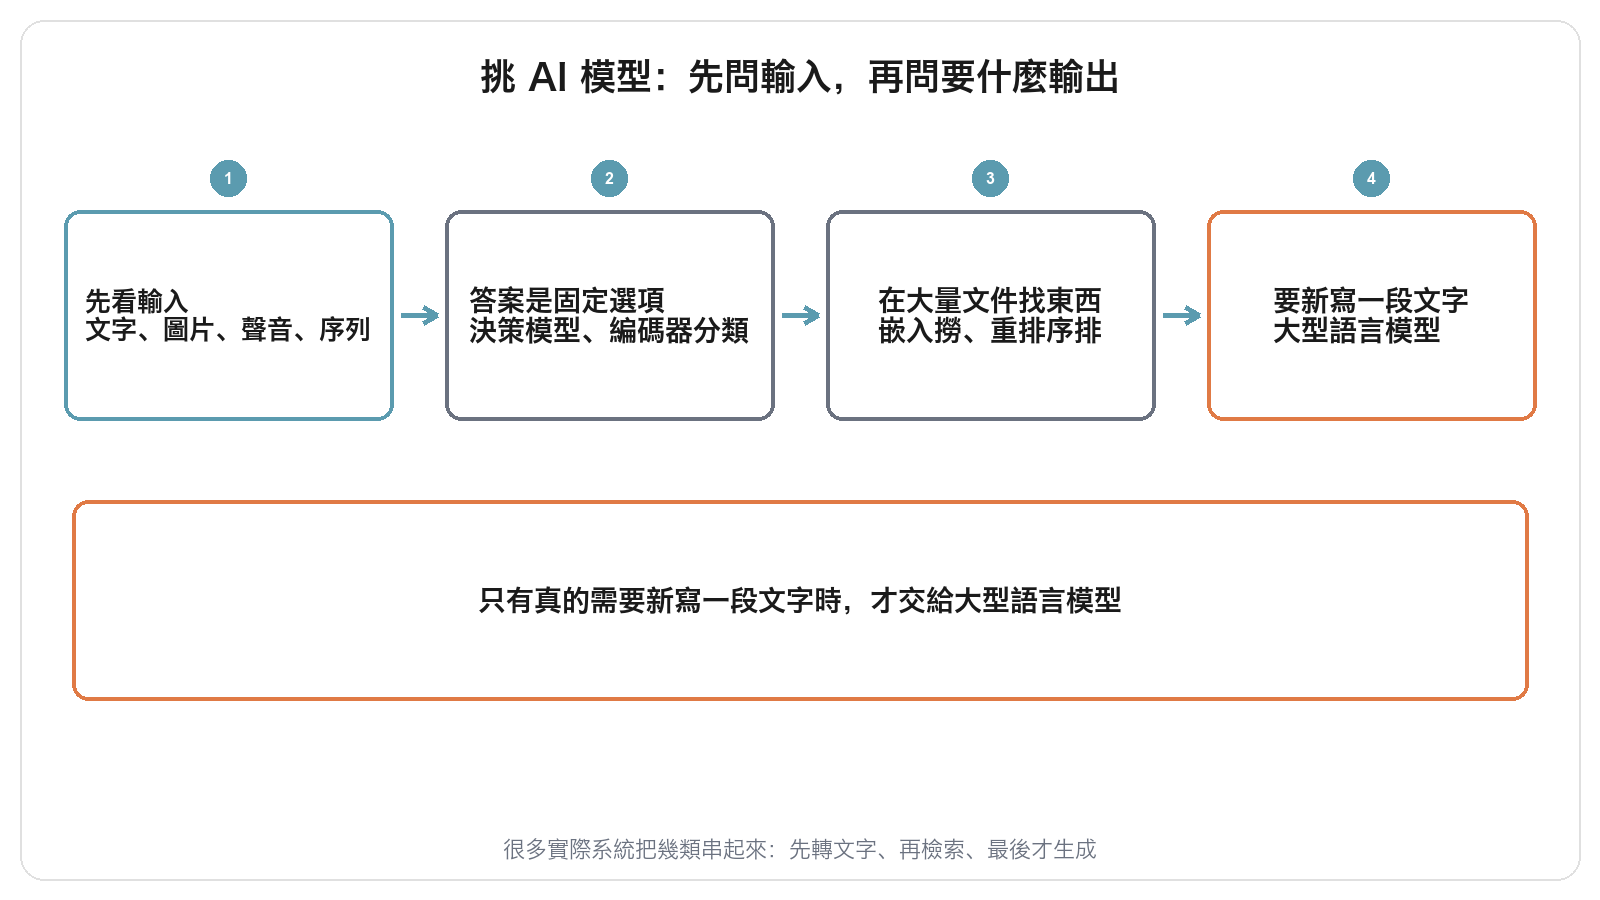
挑模型時先看手上的資料是什麼形式,再問你要的是一段新文字、一個選擇、一個分數,還是一串向量。
就像看地圖,先確認起點,再決定目的地。資料是聲音,第一步通常是語音辨識;是圖片又要文字回答,找視覺語言模型;是序列資料,找對應的生物序列模型。輸入確定之後再看輸出。答案只能落在幾個固定選項裡時,用決策模型或編碼器分類,結果穩定,也好統計。要在大量文件中找東西,就用嵌入模型撈、重排序模型排。只有真的需要新寫一段文字,才交給大型語言模型。很多實際系統會把幾類串起來,例如先轉文字、再檢索,最後才生成。
常見誤會:AI 都是聊天機器人、越大越好
最常見的誤會,是以為所有 AI 都是聊天機器人。
搜尋、推薦、字幕、垃圾信過濾這些日常功能,很多是由不寫文章的模型完成,輸出的是分數、標籤、向量或逐字稿。第二個誤會是模型越大越好。大型模型能做的事比較多,但遇到固定類別的分類這類任務,小型專用模型往往更快、更便宜,結果也更容易稽核。第三個誤會是一個模型能包辦一切。產品介面看起來只有一個對話框,背後常是好幾類模型分工。所以下次評估一個 AI 工具時,可以先弄清楚它吃進什麼、吐出什麼。