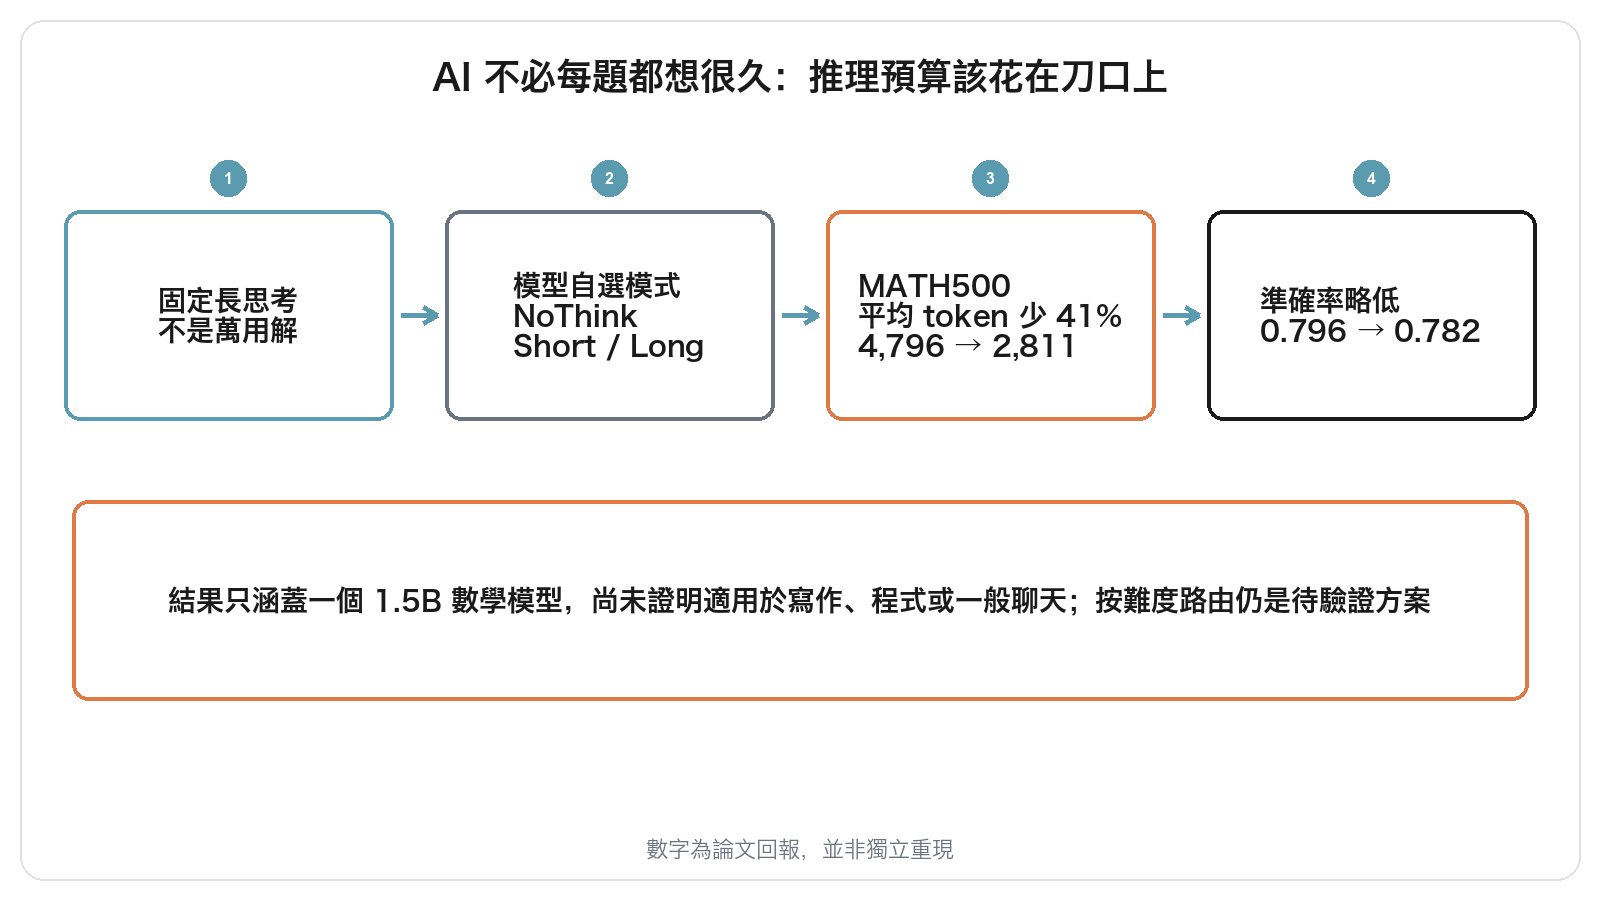
同一個 AI,能不能在簡單題少想、難題多算?2026 年一項數學推理研究讓模型自選模式,在 MATH500 平均少用 41% 回應 token,準確率則略低於基礎模型。[1]
固定長思考不是萬用解
推理預算應隨題目調整;固定讓所有問題都走長推理,可能把計算花在不需要的地方。
2024 年研究也發現,不同測試時計算策略的效果會隨 prompt 難度改變;它的 compute-optimal 策略在特定研究比較中,效率比 best-of-N 高逾 4 倍。[2] 這是單篇研究設定,不代表每種模型都能省四倍。
固定長思考就像每題都裝滿行李,簡單題的 token 也會堆積在重複驗算上;但短答案不等於正確答案。你看到模型輸出很長時,我們仍需檢查它是否真的解決題目。
落地時還要把分流成本算進去:若另呼叫分類器判斷難度,它耗用的 token 與等待時間也應計入總成本。這是部署評估建議,不是這些研究已證明的普遍效益。若高難題被誤分到短模式,省下的 token 可能換來錯誤答案;除平均值外,也應按難度檢查失敗型態。
自我路由的數學結果
2026 年研究讓一個 1.5B 數學模型以首個回應 token 選擇 NoThink、Short 或 Long 模式。[1]
該策略用 GRPO 訓練,並以獎勵設計和各模式 token 上限維持差異;研究沒有另設 router。[1] 在保留的 MATH500、三個種子平均,基礎模型準確率 0.796,自我路由為 0.782;平均輸出 token 從 4,796 降至 2,811,減少 41%。[1] 作者也報告,GSM8K 的 token 減少 76%,相近回應長度下準確率高於基準。[1]
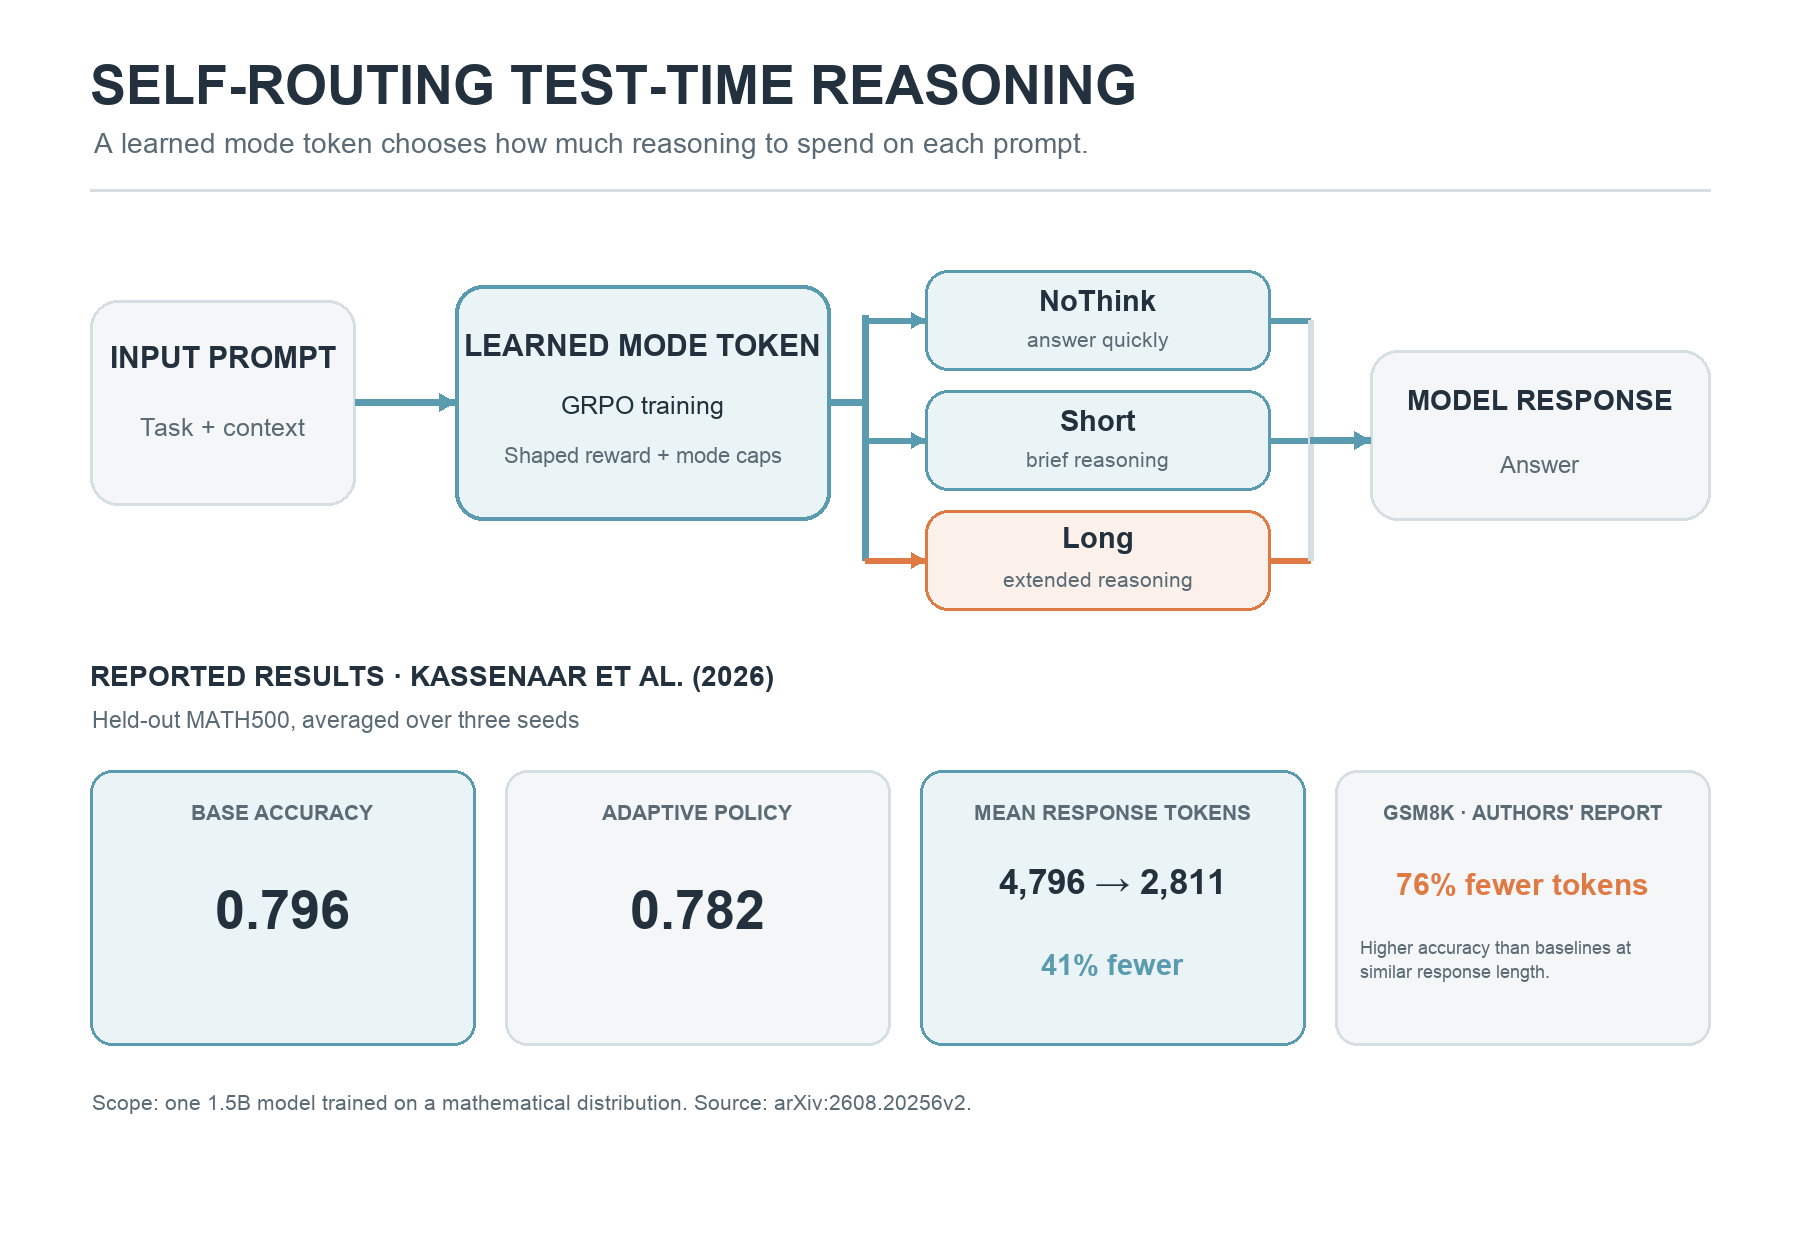
圖 1|路由方法與論文回報數據,由程式依來源 [1] 重繪,並非獨立重現。
證據邊界與實際評估
長思考並非必然有益,推理預算的效果取決於任務、模型與評分方式。
2025 年跨模型與基準的研究觀察到,追加思考的效益先升後降,作者稱為 overthinking。[3] 不過它研究的是延長推理軌跡,不是 2026 年的自我路由模型;兩種方法不能混為同一實驗。
目前最強的新結果仍只涵蓋一個 1.5B 模型、數學訓練分布與三個種子;研究未證明同樣省 token 的效果適用於寫作、程式或一般聊天。[1]
圖 2 整理三項研究的不同結論與範圍,並非把數值拼成共同曲線。[1][2][3]
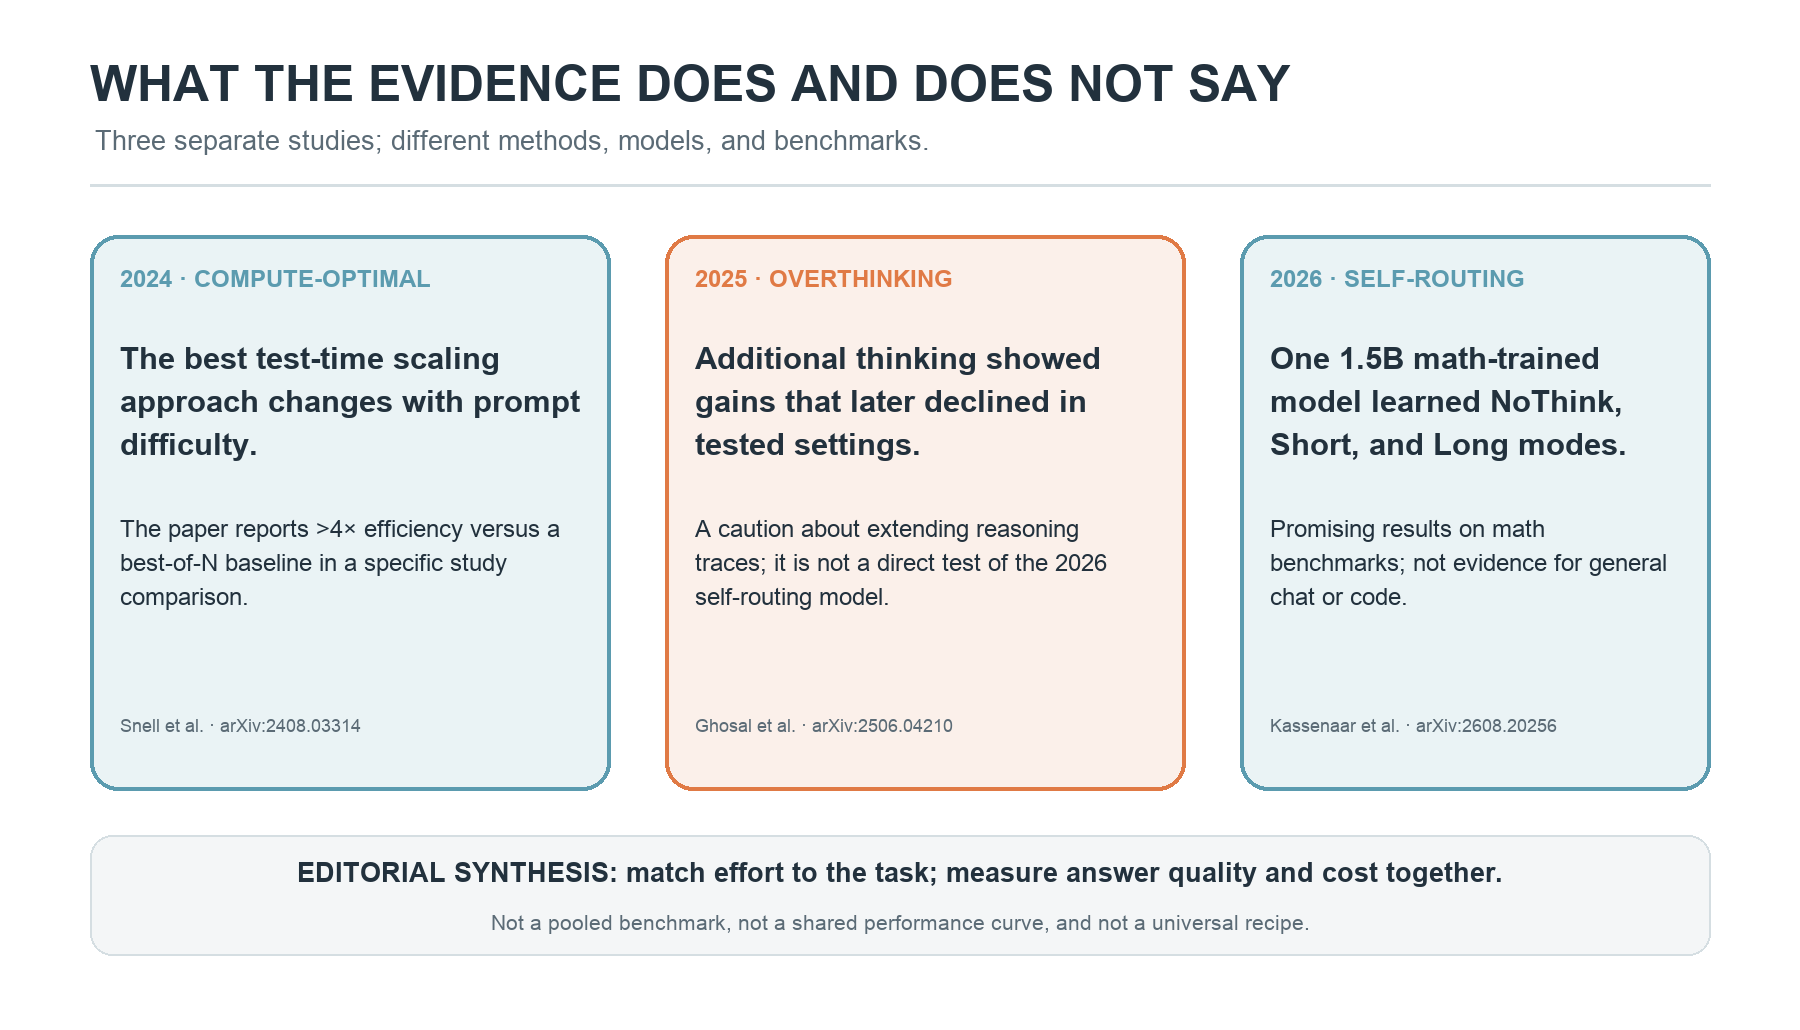
圖 2|三項研究的證據範圍彼此獨立;這是文獻整理,不是共同基準曲線。[1][2][3]
效率比較還依賴題集與成本定義。[2] 團隊可固定代表性題集與預算上限,逐層對照正確率、token 和延遲。 如果簡單題省得多,卻讓難題錯得更多,平均數就可能遮住取捨,這是按難度分層檢查的理由。[1][2] 這些量測應在目標模型與部署環境重做,不能把論文的 token 差異直接當成成本節省。[1][2]
當你比較模型或部署本地 LLM 時,別把「思考越長」當成品質保證。你也可先在代表性題集上分層測正確率,再一併記錄 token 與延遲。我們應把按難度路由當成待驗證方案,依實際成本與任務表現決定,而不是直接設成通用預設。[1][2][3]