想不起關鍵字,也能找到那篇論文
想像一下,資料夾裡堆積了幾百篇論文,你想不起其中一篇的關鍵字。
你只記得它講「少睡之後記憶變差」,不確定作者寫的是 sleep deprivation 還是 sleep loss。你知道關鍵字搜尋為什麼常在這裡落空嗎?因為它只認字面。用錯詞就撈不到。嵌入模型把一段文字轉成一串固定長度的數字,讓電腦依意思比對,你直接打問句就能找出最接近的段落。完整分類見AI 模型種類地圖。
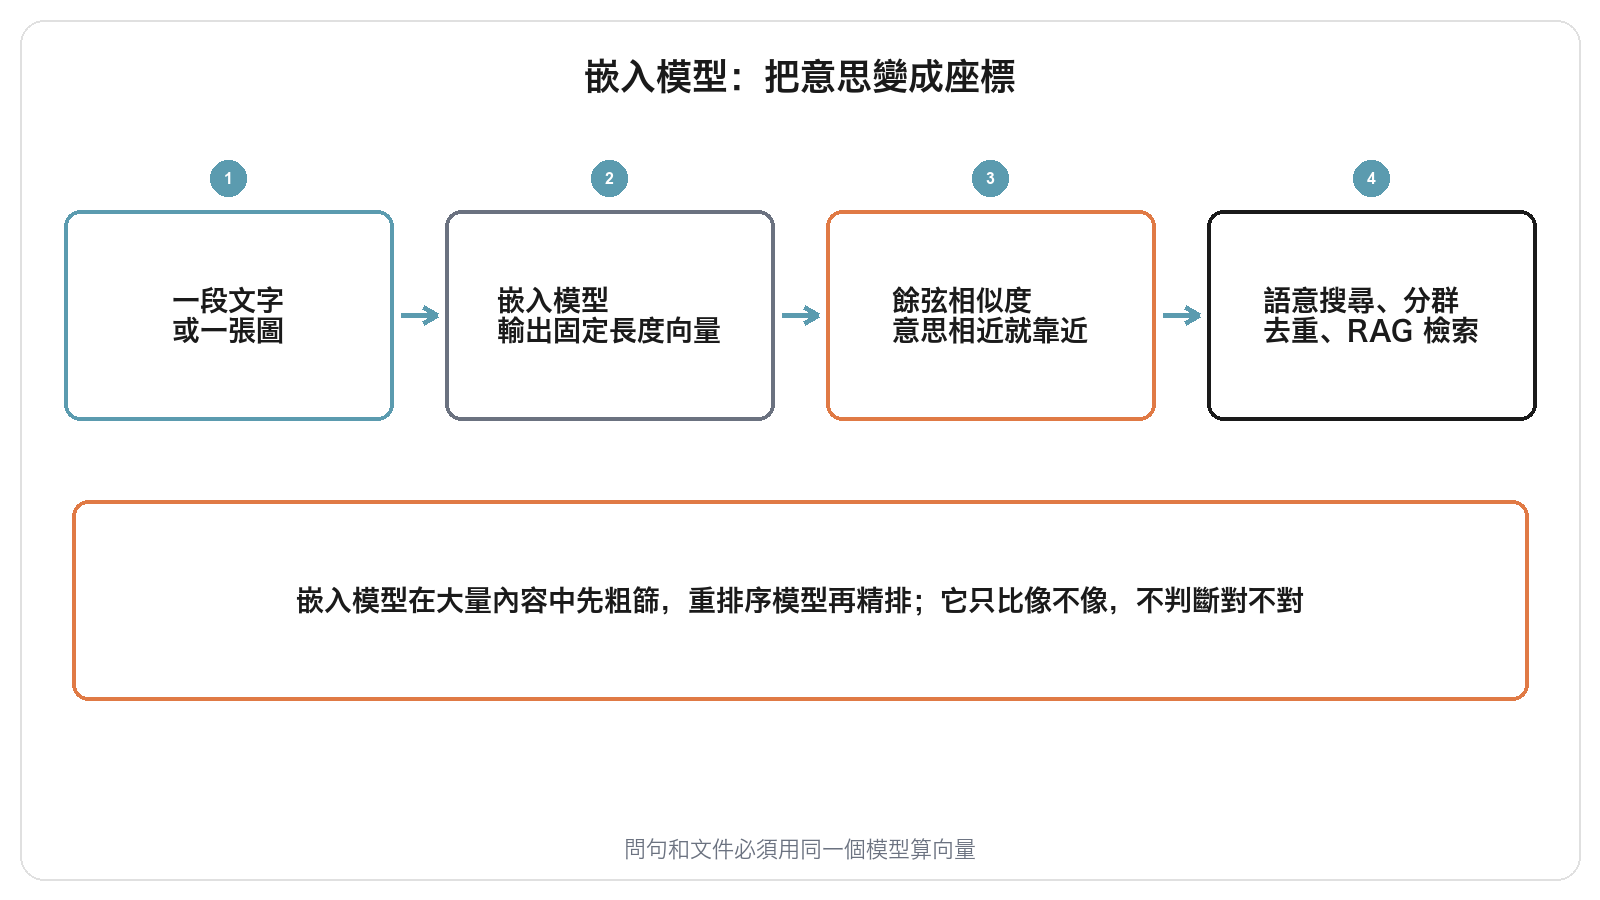
輸入一段內容,輸出一個向量
嵌入模型輸出一個向量,不論輸入一個詞或一整段話,長度都一樣。
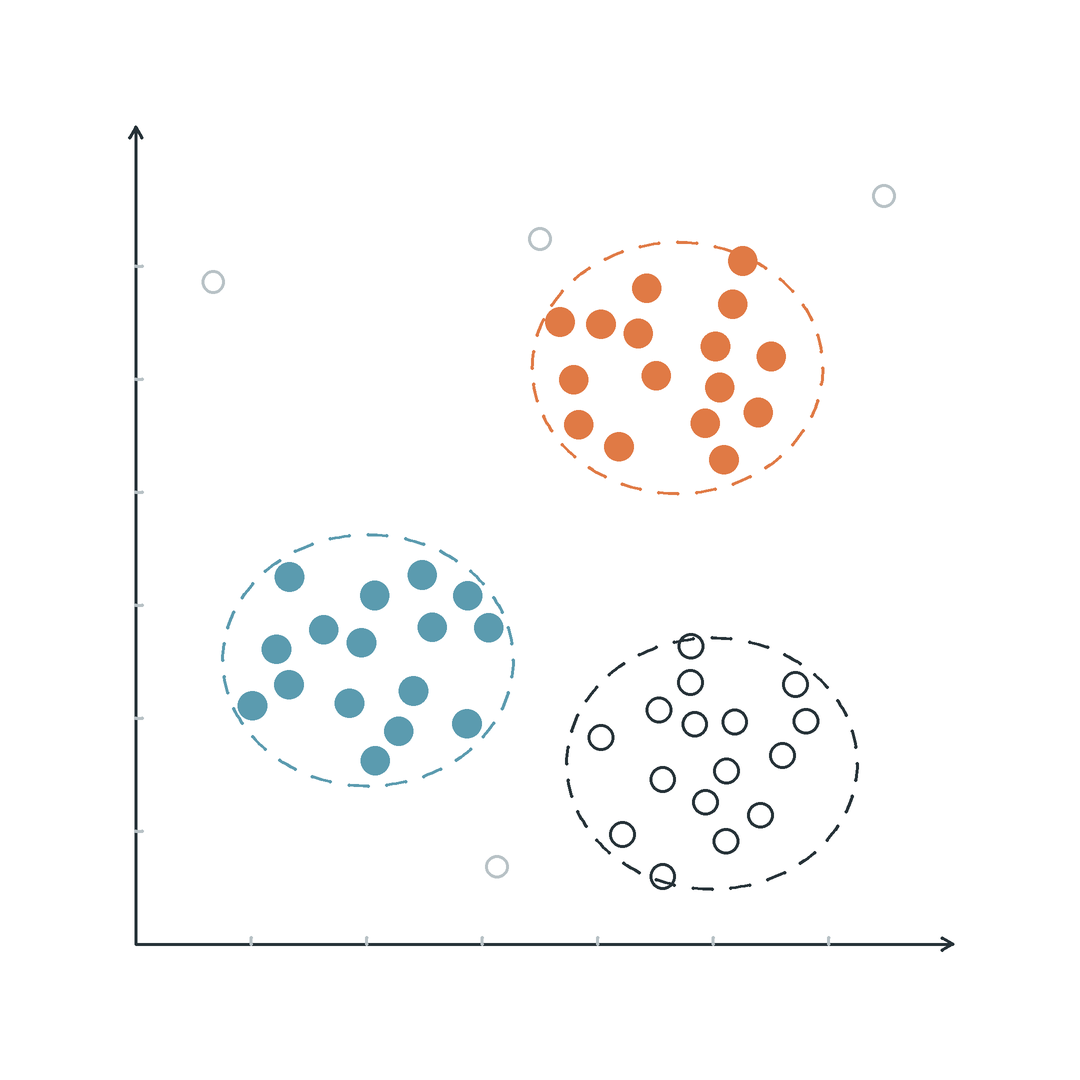
向量就像地圖上的座標,只是方向多達幾百甚至上千個。word2vec 替每個單字算出向量,意思相近的字落在附近 [2]。Sentence-BERT 把它延伸到句子,用成對句子微調 BERT,讓意思相近的兩句向量也靠近 [1]。模型本身不寫文字。它只負責給座標。
意思相近,座標就靠近
兩段內容像不像,看兩個向量方向多接近,常用量法叫餘弦相似度。
把向量想成從原點射出的箭:夾角越小,餘弦值越接近 1,意思越像;夾角接近直角時值接近 0,大致無關。文件向量能事先算好存著,查詢時只算問句的向量,所以很省時。Sentence-BERT 論文的對照:在 1 萬個句子中找最相似的一對,讓 BERT 把句子兩兩一起讀要用掉約 65 小時,先各自算好向量再比較約 5 秒 [1]。
能做什麼:語意搜尋、分群、去重與 RAG 檢索
內容能比遠近,就能拿來搜尋、分群、找重複,以及替大型語言模型找資料。
把論文切段、各自算出向量後,問句「睡眠不足會不會影響記憶」就能找到寫 sleep deprivation 的段落。兩邊不必有共用的字。同一批向量也能分群看主題,或找出幾乎相同的檔案。RAG(檢索增強生成)的第一步也是如此:先用向量撈出相關段落,再交給大型語言模型作答 [3]。DPR 的檢索器用兩個編碼器分別把問題和段落轉成向量 [4]。CLIP 則如同把圖片和文字標在同一張地圖上,一句描述就能找出對應的照片 [5]。
限制:它比的是像不像,不是對不對
嵌入模型只衡量意思有多接近,不判斷內容是否正確。
主題相同的錯誤說明和正確說明,向量可能非常接近。還有領域落差:用一般網路文字訓練的模型,未必分得清生醫縮寫和基因名,要換用該領域模型,或拿你自己的資料抽查。問句和文件也必須用同一個模型算向量,好比不同地圖的座標不能混用。切段同樣要拿捏:整篇論文壓成一個向量,細節會被平均吃掉;不過切太碎,句子又會和上下文拆開。
什麼時候選它:先粗篩,再精排,最後才生成
要從大量內容快速撈出可能相關的一批,選嵌入模型當第一關。
為什麼不一開始就用更細的模型?因為細讀很慢。嵌入模型把問句和文件分開算,所以快。代價是兩邊沒一起讀過。重排序模型會把問句和每段候選一起讀,通常只排嵌入模型撈回的前幾十筆。最後由大型語言模型根據段落寫答案。要替文件貼上固定類別,例如「臨床研究」或「動物實驗」,用標好的例子訓練編碼器分類模型更直接。不靠向量檢索的做法見 DecisionRAG 介紹。