一張圖加一個問題進去,一段文字出來
視覺語言模型(vision-language model,VLM)讀進一張圖片和一段文字問題,輸出一段文字回答。
想像一下,你把一張長條圖的截圖交給它,問「Y 軸的單位是什麼」,它會找到軸標籤,再用一句話回答你。為什麼純文字的大型語言模型做不到這件事?因為它收不到圖片。在AI 模型種類地圖上,視覺語言模型佔的是「圖片加文字進、文字出」那一格。
它怎麼看圖:把圖片切成小塊,轉成語言模型讀得懂的詞
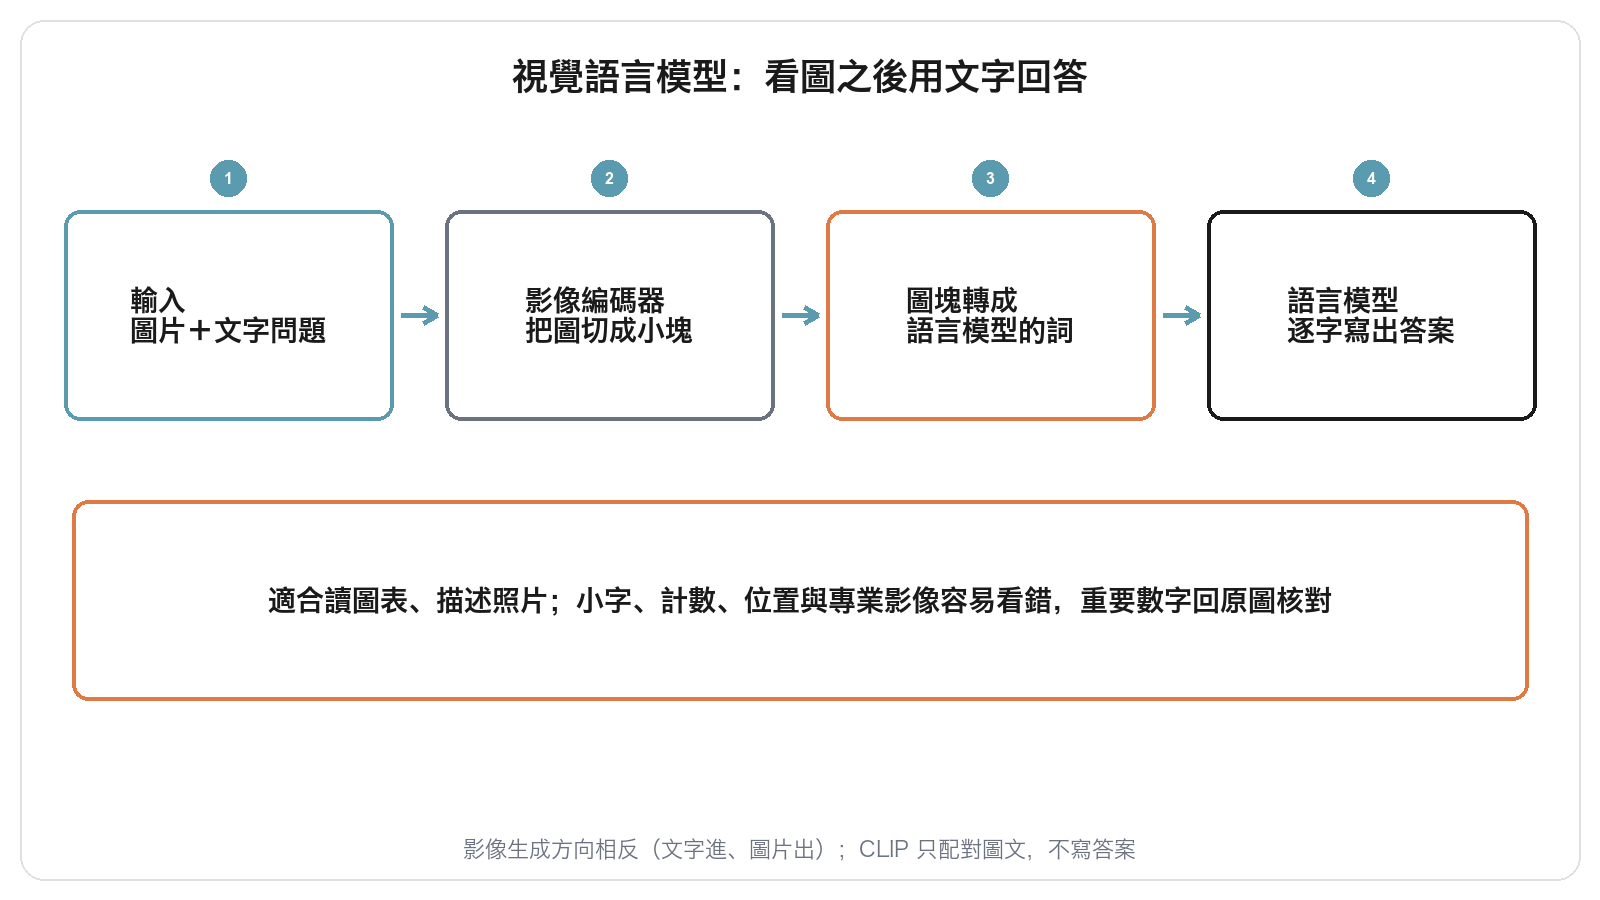
多數視覺語言模型由兩個部分接成:影像編碼器管著看圖,大型語言模型管著寫出答案。
語言模型怎麼讀圖?影像編碼器先把圖片切成固定大小的小方塊,像把一張照片剪成一格格拼圖。Vision Transformer(ViT)證明這種切塊做法可以直接用來辨識影像:每一塊先轉成一串數字,模型再計算各塊之間的關係。以 LLaVA 為例。它沿用 CLIP 現成的影像編碼器,再用一層簡單的投影把每塊圖的數字轉成語言模型「詞」的格式,接在你的問題前面。所以對語言模型來說,這些圖塊就像一段它讀得懂的特殊文字,讀完後照平常方式逐字寫出答案。LLaVA 又用圖文問答資料訓練,讓模型學會依指示回答圖片相關的問題。
Flamingo 走另一條路線:它在語言模型內部插入額外的層,讓模型寫字時能隨時回頭參考圖片,因此也能處理多張圖與文字交錯的輸入。
適合做什麼:先看一眼,替你讀出圖上的內容
日常最常見的用途是描述照片、讀表格或圖表截圖,以及從掃描頁面抽出文字。出國時拍下路標或產品說明書,它能讀出上面的字,再翻成你要的語言。
在研究工作裡,它適合當看第一眼的助手。拿到一篇論文的圖,可以先問它「這張圖比較了哪幾組」「橫軸代表什麼」,掌握圖的架構後,再決定要不要細讀原文。整理堆積的掃描表單,做法如同讀圖:先讓它把欄位內容轉成文字,再由人逐筆確認。
常看錯的地方:小字、數量、位置與沒見過的影像
它最常在五種情況下出錯。碰到很小的字和密集的數字表,它可能讀錯一位數或對錯欄;請它數一張圖裡有幾個細胞或幾個人,答案常常不準;問「哪個物體在左上角」這類精確位置,也容易答偏。顯微鏡切片、放射影像這類訓練時很少見的專業影像,它可能給出聽起來專業、實際上沒有根據的判讀。它還可能描述圖中不存在的細節,而且語氣跟答對時一樣篤定。
這些就是它目前的限制。所以凡是要寫進報告的數字,都要回到原圖或原始資料核對;專業影像的判讀,仍要交給受過訓練的人。
跟鄰居怎麼分:大型語言模型、影像生成與嵌入模型
挑工具時,先看手上有沒有圖,再看你要的輸出是什麼。
**大型語言模型只收文字、看不到圖片,問題不涉及圖時用它就夠了。影像生成模型方向相反,文字進、圖片出,要的是一張新圖才找它。嵌入模型**裡的 CLIP 如同視覺語言模型,也同時處理圖和文字,但它把兩者放進同一個座標空間,用距離判斷哪張圖配哪句話,因此適合以文搜圖或分群,卻不會寫出回答。要看完一張圖再用句子回答你,就交給視覺語言模型。