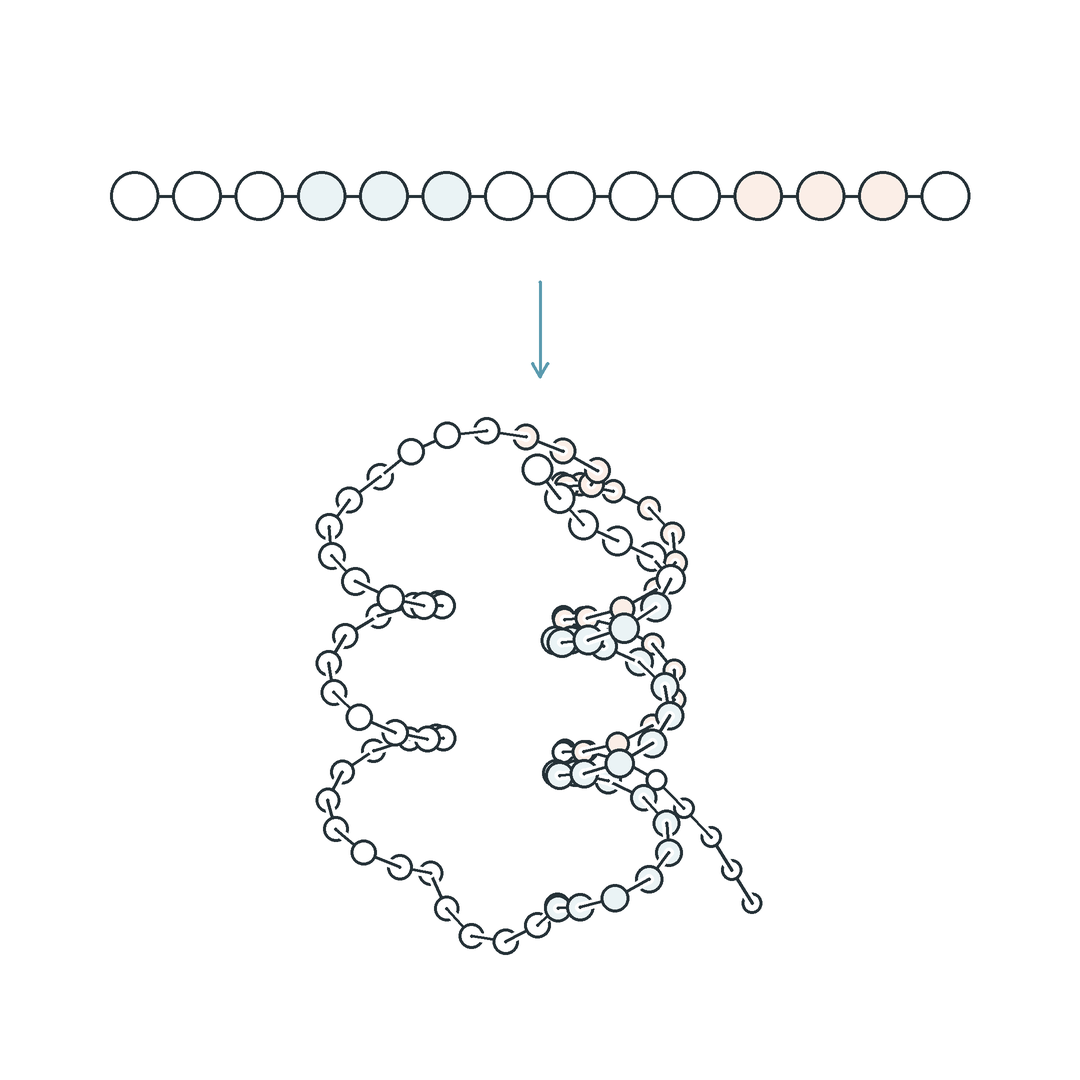
輸入與輸出
想像一下,你手上有幾十個候選突變,實驗一次只做得了幾個,你會怎麼決定先做哪一個?
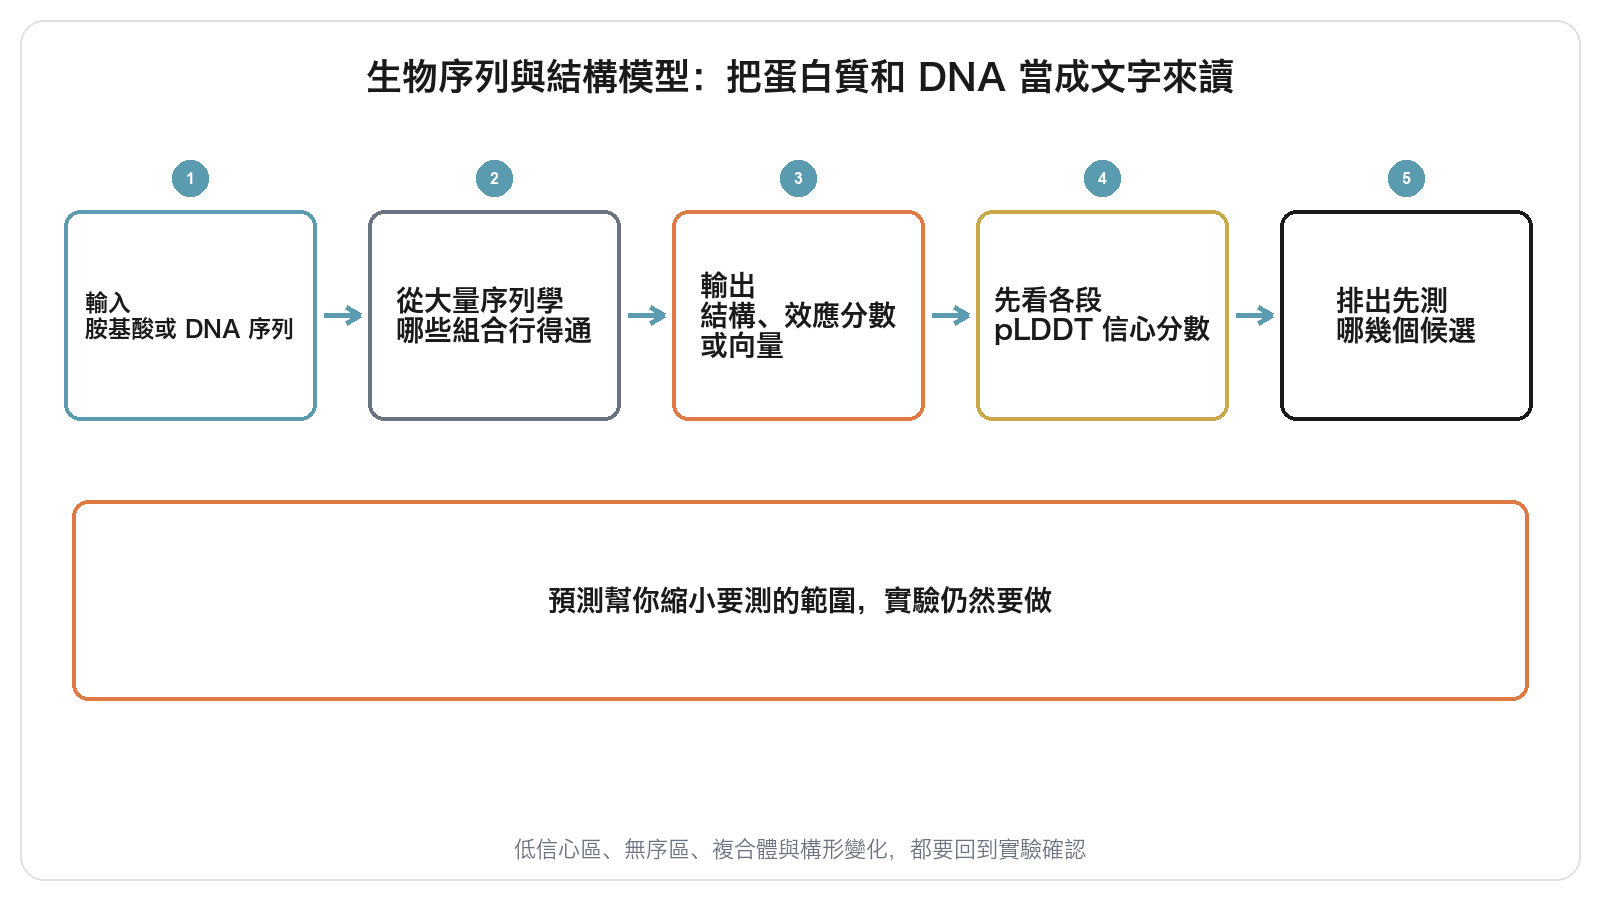
生物序列與結構模型讀進胺基酸序列或 DNA 序列,輸出三種東西之一:預測的立體結構、突變或變異的效應分數,或代表整段序列的一串數字。
在 AI 模型種類地圖上,它如同讀生物序列的大型語言模型。
從前後文猜胺基酸
蛋白質由 20 種胺基酸串成,寫下來就像一段只有 20 個字母的文字。
蛋白質語言模型訓練時遮住序列裡的部分胺基酸,讓模型依前後文猜回來,就像大型語言模型從前後文猜字。Rives 等人用約 2.5 億條蛋白質序列訓練這類模型,發現內部表示帶有二級與三級結構的資訊,訓練時卻沒給過結構資料。ESM-2 把同樣做法放大,Lin 等人再接上結構模組,做成只憑單一序列就能預測結構的 ESMFold。
為什麼沒看過結構的模型學得到結構?因為演化淘汰了行不通的序列,留下來的序列記錄了哪些組合行得通。
結構預測與信心
AlphaFold 讀進一條蛋白質序列,加上從資料庫找來的同家族序列比對,輸出每個原子的預測座標。
它同時替每個位置給一個 0 到 100 的 pLDDT 分數。依 EMBL-EBI 的說明,高於 90 通常主鏈與側鏈都可靠,高於 70 通常主鏈正確;低於 50 的區段,可能本身就是沒有固定形狀的無序區,也可能是模型資訊不足。不過 pLDDT 只衡量局部,兩個結構域之間的相對位置要另外判斷。所以你讀預測結構時,先看各段 pLDDT,再決定哪些部分可用。
DNA 模型
DNA 模型讀基因體序列,輸出它在不同細胞類型中的訊號,例如基因表現量。
Enformer 能整合遠至約 10 萬個鹼基外的序列資訊;把某個鹼基換掉再預測一次,就能估計這個變異對它管著的基因表現的影響。本站寫過的 AlphaGenome Atlas 也屬於這一類。
適合用在哪
每個實驗都要用掉時間與材料,所以回到開頭的情境,先用效應預測排序,從最可能有影響的開始驗證。
你研究的蛋白質若還沒有實驗解出的結構,預測結構能提供工作假說,例如判斷某個突變落在內部還是表面。
容易讀過頭的地方
預測是推估,不是測量,這類模型有幾個限制要先知道。
結構預測給的是一種形狀,然而蛋白質在細胞裡會隨結合對象改變構形;EMBL-EBI 也提到,有些無序區要結合其他分子才折疊,AlphaFold 有時會把它們預測成已折疊且信心很高。蛋白質複合體與構形變化也超出單鏈預測範圍。訓練資料多堆積在研究較多的蛋白質家族;AlphaFold 原論文報告,同源序列很少時準確度明顯下降。DNA 變異的效應分數同樣是排序依據,不是臨床判讀。
和其他模型的分工
它和大型語言模型差在字母表與訓練資料,機制相同。
它和嵌入模型也有交集:蛋白質語言模型的內部表示可以當成序列向量,用來找序列不太像、功能卻相近的蛋白質。問題若是在幾個固定選項裡挑一個,那是決策模型的工作。想從序列得知結構或變異影響時,才輪到這一類。它幫你縮小要測的範圍,實驗仍然要做。