導讀:這篇預印本換掉了 AI 找資料的那一步。
再聰明的 AI,也答不出檢索器沒找到的資料
為什麼 AI 偶爾會一本正經地答錯?問題常常出在它拿到的資料,而不是它的腦袋。
想像一下,你請 AI 回答「諾蘭 2000 年那部電影的主角是誰」。系統通常先用檢索器撈幾段文字再交給模型作答,這叫 RAG(檢索增強生成)。關鍵字比對可能把同樣 2000 年上映的《神鬼戰士》排在前面,答案所在的《記憶拼圖》反而落榜。康乃爾大學 Wan 等人的預印本稱之為「能力不對稱」。生成模型越來越強,挑資料的檢索器卻還在算字頻、比向量。它漏掉的東西,後面的模型再強也補不回來。
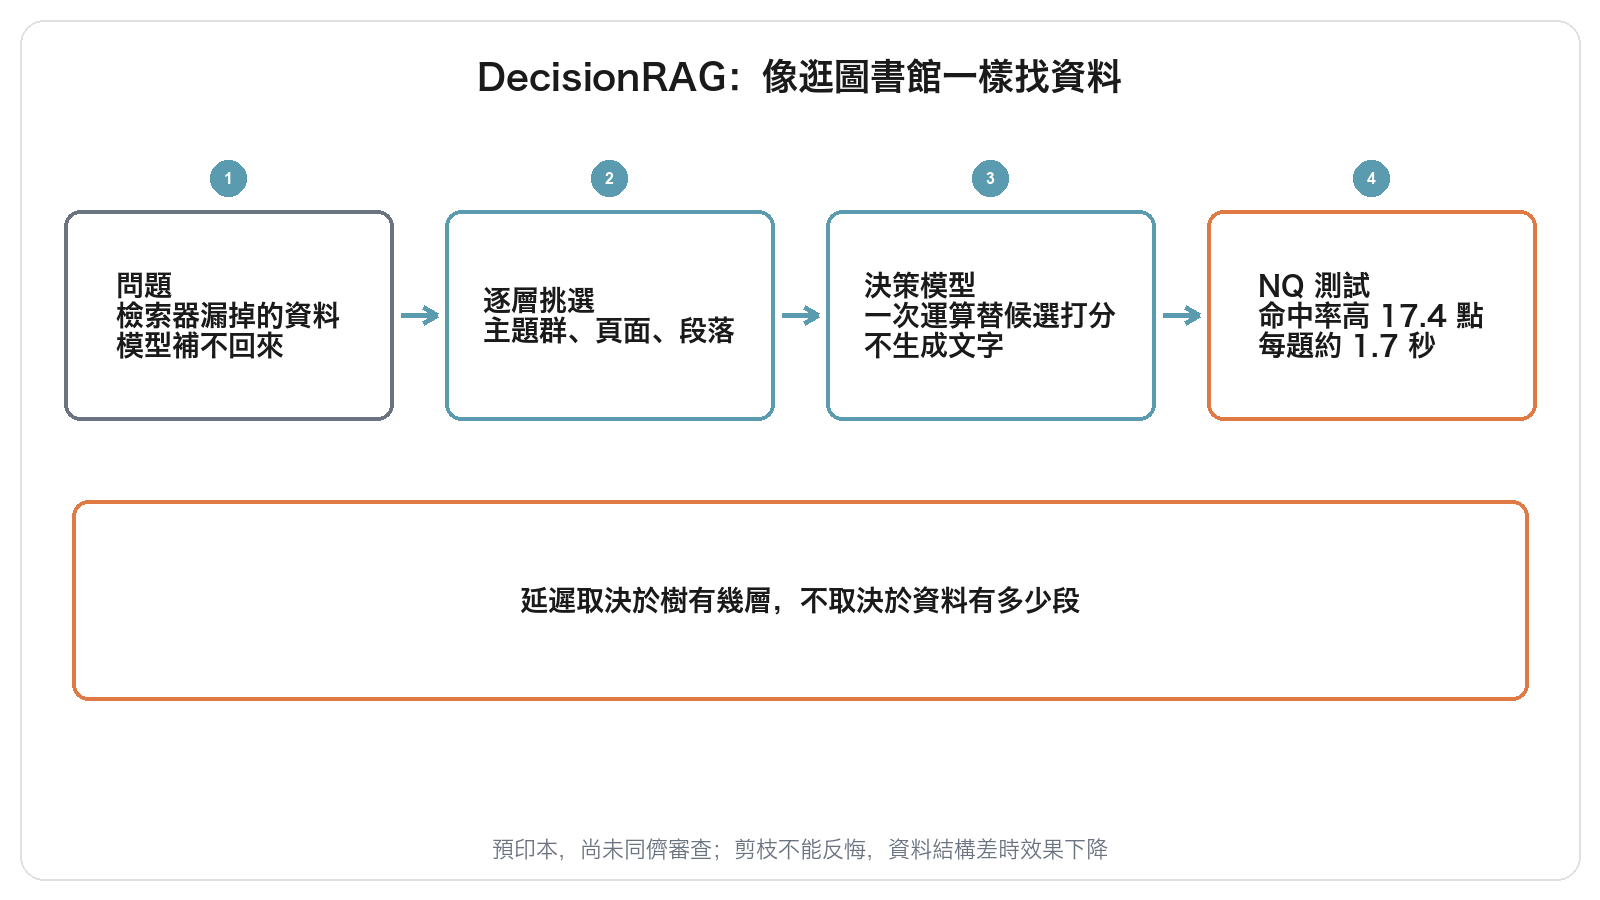 一圖看懂:DecisionRAG 沿著主題、頁面、段落逐層挑資料
DecisionRAG 把「搜尋」改成「沿著書架逐層挑選」
DecisionRAG 不用檢索器,改由決策模型逐層挑出值得看的分支。
它找資料就像你逛圖書館一樣:先到電影區,挑出幾本諾蘭的書,再翻到需要的那頁。資料先排成「主題群、頁面、段落」的樹。每一層由決策模型判斷哪些分支值得往下走,沒選上的整支剪掉,所以底下的段落不再評分。
決策模型不生成文字。你把問題和一排候選交給它,它在一次運算裡替每個候選回一個「相關」的機率。因為所有候選讀同一份上下文,就像把幾本書並排在桌上比對,所以分數可以直接比較。作者在 MultiDoc2Dial 上實測,放在一起評分比逐段分開評分,第一名命中率高 7.7 個百分點。
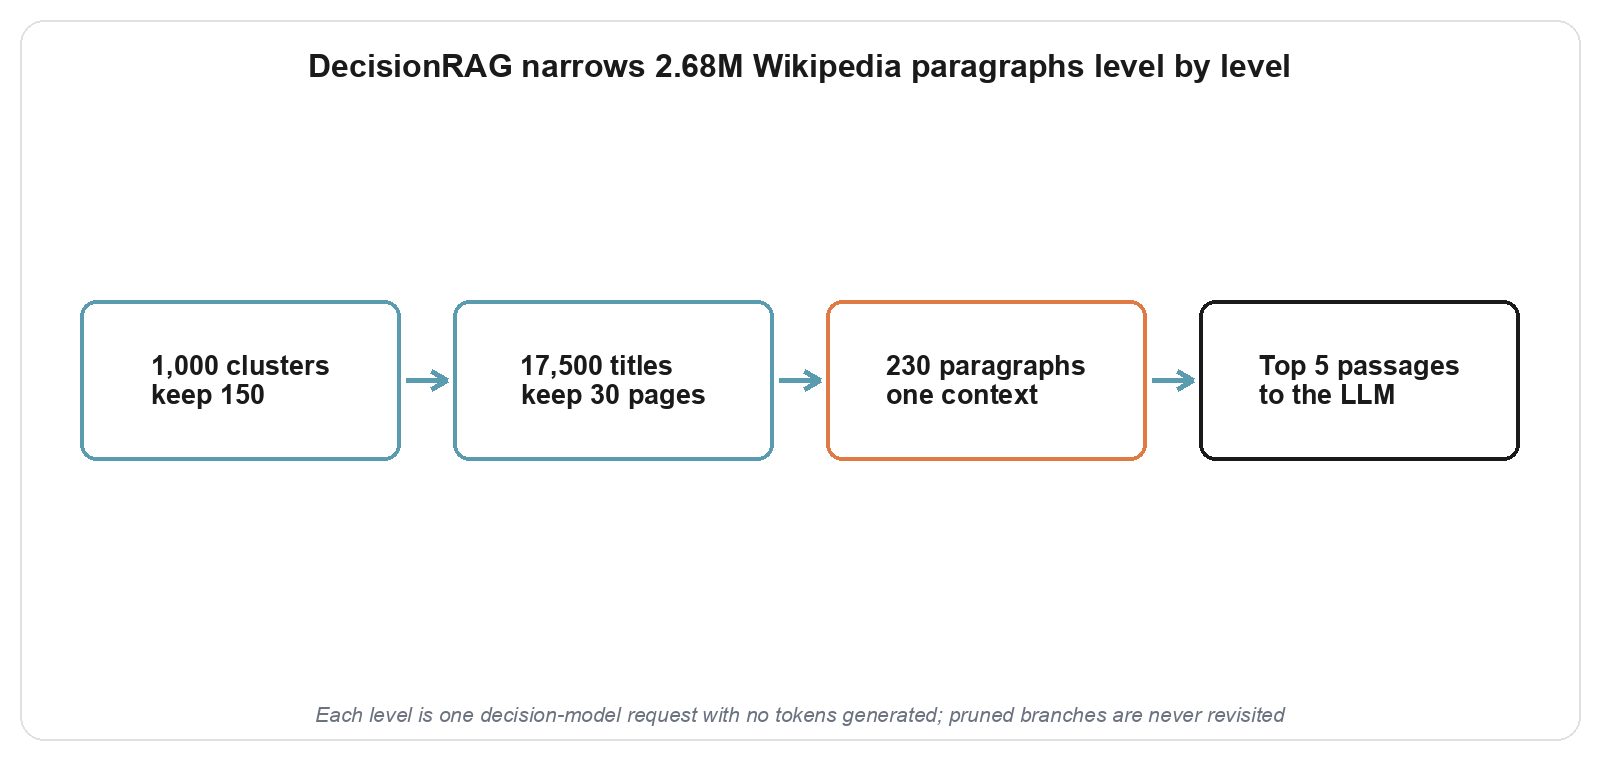 圖 1:DecisionRAG 在 Natural Questions 上逐層縮小範圍的流程
268 萬段維基百科,每題約 1.7 秒找完
樹有幾層才決定速度,資料量的影響小得多。
在 Natural Questions 測試中,268 萬段維基百科先分成 1,000 個主題群,模型保留 150 群,只讀了 16% 的頁面標題。和「向量檢索加 80 億參數重排序模型」相比,第一名命中率高 17.4 個百分點。每題中位延遲約 1.7 秒。若改讓 GPT-5 逐字寫出要保留哪些分支,準確率互有勝負,速度卻慢 34 到 145倍。
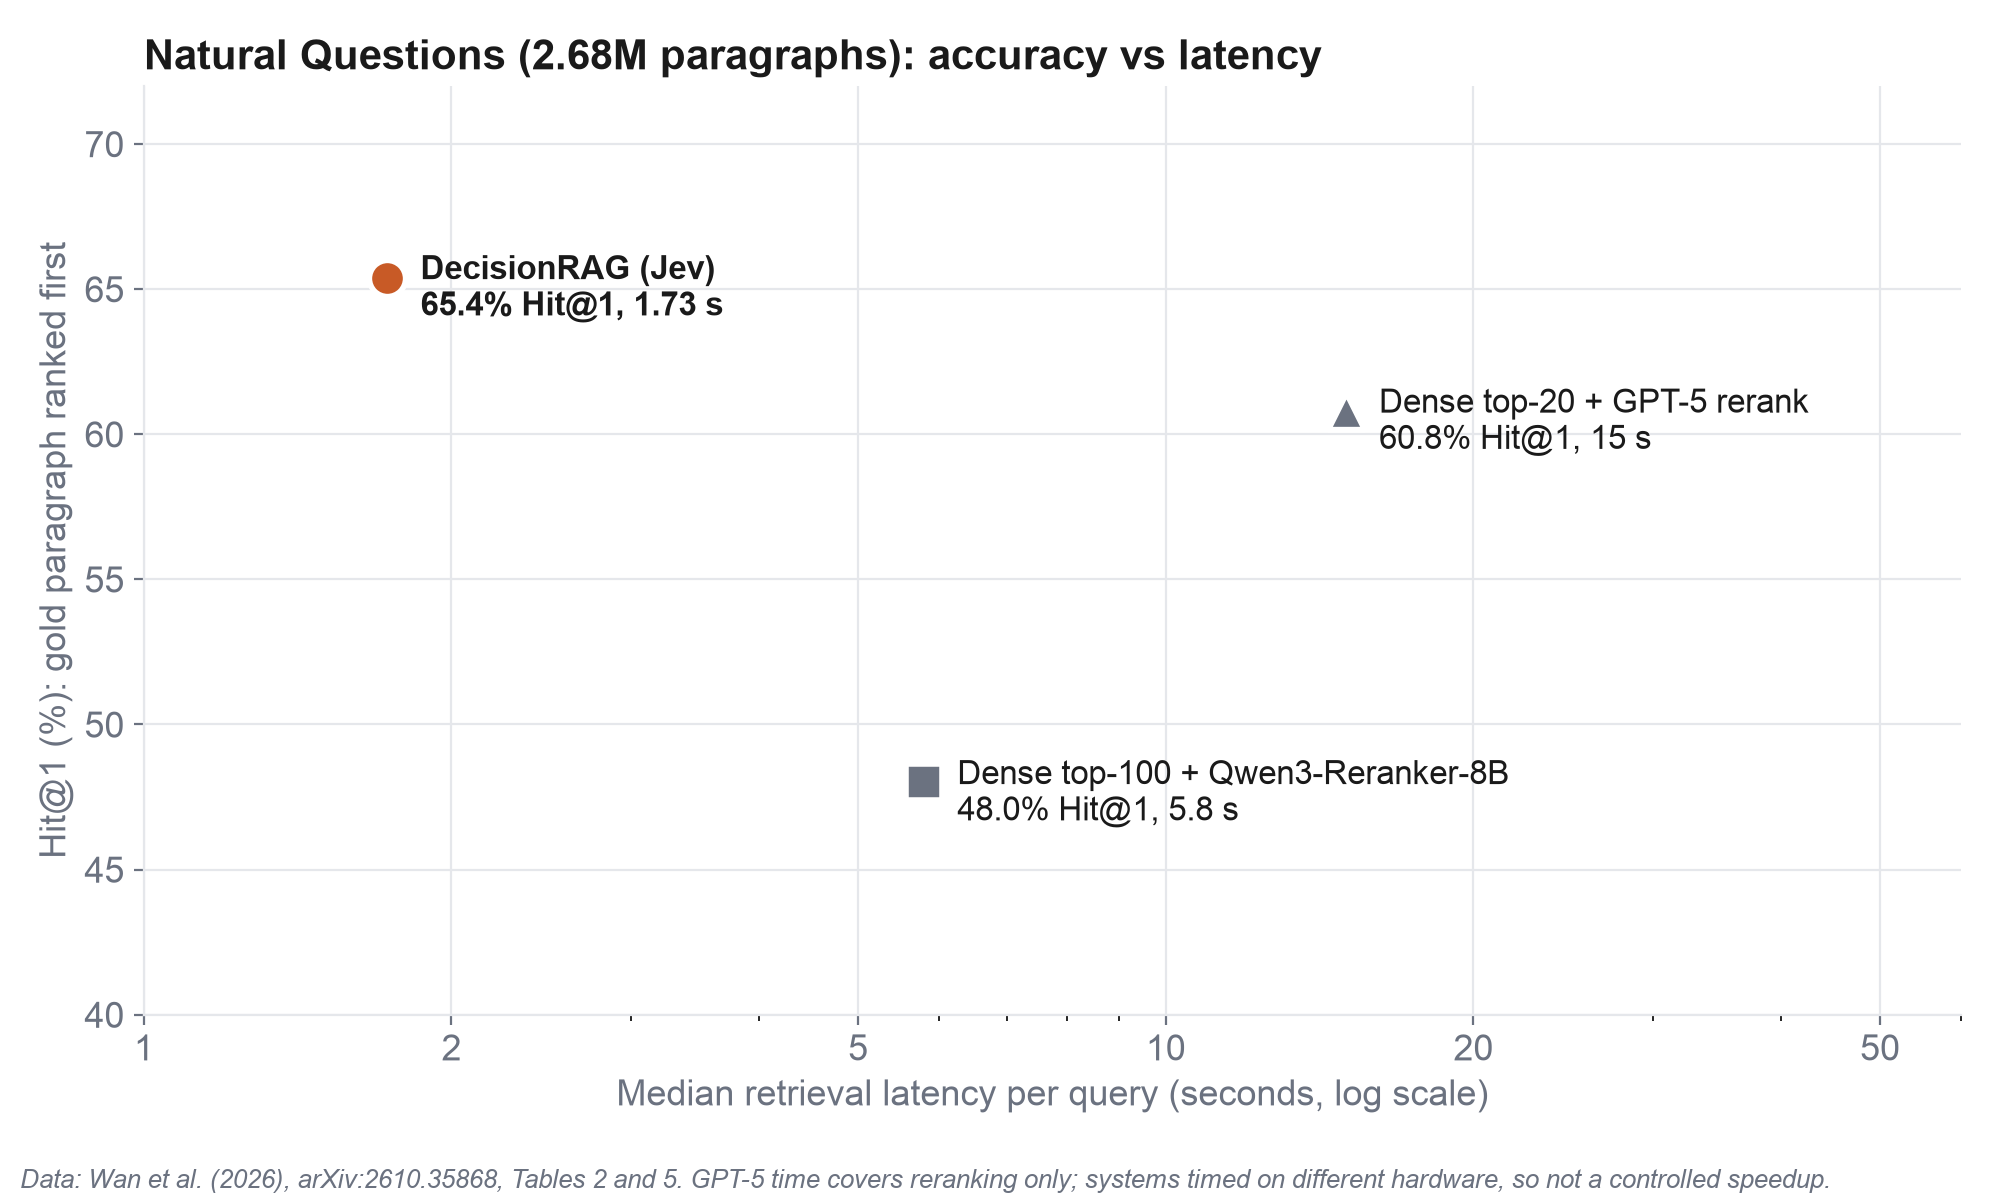 圖 2:Natural Questions 上三種檢索方式的命中率與延遲
不過這是尚未同儕審查的預印本,主實驗的 Jev 也是商用決策模型服務,作者也列出幾項限制。剪枝不能反悔,所以主題群一旦誤刪,裡面的答案就找不回來。資料結構凌亂或標題含糊時,效果也會下降。GPT-5 重排序在 ConditionalQA 的第一名命中率仍較高,在 Natural Questions 的每題成本也較低。各方案測速的硬體不同,作者也註明這不是嚴格對照。
搭配閱讀:誰來排書架,以及整理資料的代價
另外三篇預印本談的是書架怎麼排,以及整理的代價。
Librarian Agents 訓練代理在提問前把文件重整成資料夾,等於先排好書架,在 BrowseComp-Plus 的 50 題上比最強基線高 33 個百分點。DecisionRAG 則在提問當下利用現成結構,兩者一前一後。
Memory Tax 在三個個人助理對話記憶基準上發現,很多記憶系統輸給單純的 RAG,因為重新整理資料時可能把證據藏起來。DecisionRAG 的主題摘要也是整理,寫不好就會錯剪整個分支。Beyond Token Savings 則觀察到,在 Terminal-Bench 搭配 Qwen 的設定下,只用三分之一的 token 仍可能慢 20% 到 80%,部分原因是多出來的摘要呼叫。DecisionRAG 壓低延遲,靠的也是減少依序呼叫的次數。
你的 AI 答非所問時,怎麼判斷是誰的錯?先看它拿到哪幾段資料,很多時候答案就在那裡。