一段文字進去,出來的是標籤
編碼器分類模型讀進一段文字,輸出一個標籤;序列標註則替文中的每個字詞各貼一個標籤。
想像一下,你桌上堆積了 3000 篇論文摘要,你想先挑出相關的幾篇,就像替每篇摘要貼上「相關」或「不相關」的標籤,再把提到的基因、藥物和疾病名稱圈出來。前一件事是分類。判斷評論正負面也是同類工作。後一件事是序列標註,最常見的是命名實體辨識(NER):模型逐字判斷每個字是基因名的開頭、中段,還是都不是。在 AI 模型種類地圖上,這一類吃進文字、吐出事先定好的標籤,不寫新句子。
怎麼運作:先讀懂整句,再接一個小分類器
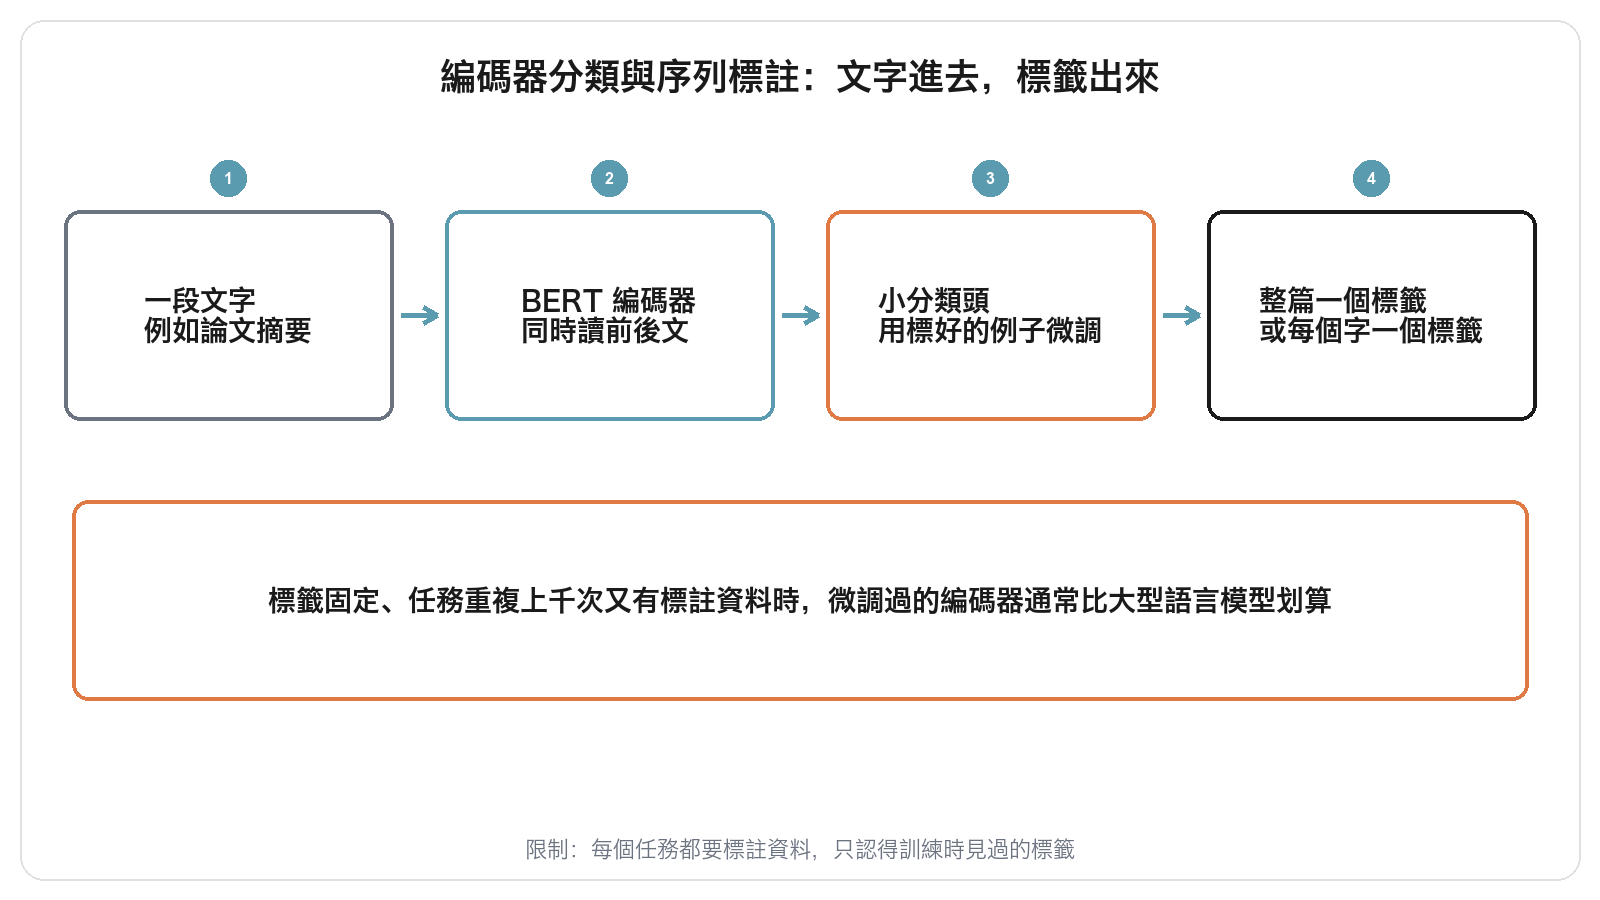
這類模型分兩層:下層編碼器把整句讀成一組數字表示,上層小型分類頭再依此選出標籤。
典型代表是 2018 年發表的 BERT。它先在大量文字上預訓練:把句子裡部分字詞遮起來,要模型參考左右兩邊的文字猜回來,因此每個字的表示都帶著前後文。做特定任務時,在編碼器上加一層輸出層,再用人工標好的例子繼續訓練,這一步叫微調(fine-tuning)。分類時,分類頭看整句給一個標籤;序列標註時則替每個字各給一個。
模型怎麼知道一個字屬於藥名?要看它前後寫了什麼。所以更早的 NER 模型(Lample 等人,2016)已採用雙向讀取。
生醫文獻:BioBERT 與 PubMedBERT
生醫文字充滿專有名詞與縮寫,用生醫文獻預訓練的編碼器在這類文字上通常比通用版本表現好。
BioBERT 拿 PubMed 摘要與 PMC 全文接著預訓練 BERT,作者報告它在生醫命名實體辨識、關係擷取和問答任務上都勝過原版 BERT。PubMedBERT 則只用 PubMed 文字從頭預訓練。作者比較後認為,在生醫這種文字量充足的領域,從頭訓練比從通用模型接著訓練效果更好。如同開頭那疊摘要,常見用途是標出基因、化合物與疾病名稱,再整理成可搜尋的表格。
強項與限制
它的強項是小、快、便宜,輸出格式固定;限制是每個任務都要標註資料,且只認得訓練時見過的標籤。
這類模型通常比大型語言模型小得多,一般電腦就跑得動,你的資料也不必送到外部服務。輸出只會是預先定義的標籤,所以對錯能直接統計。代價是彈性。你想多加一個「臨床試驗」類別,就得補標資料、重新微調,這都要用掉人力。文件寫法與訓練資料差很多時,例如從期刊摘要換成病歷,準確度可能下降,你得拿新資料重新評估。
什麼時候選它,而不是問大型語言模型
任務會重複上千次、標籤固定、你手上又有標註資料時,微調過的編碼器通常比較划算。
既然大型語言模型不必訓練,提示裡寫清楚類別就能分類,為什麼還要微調編碼器?因為兩者適合的階段不同。前者適合試做或類別還在變動的時候,不過逐字生成答案會吃掉較多時間,同一段文字問兩次也可能得到不同說法。決策模型如同編碼器分類,也從固定選項中挑一個:讀進情境和列好的選項,替每個選項給出機率,有些本身就是編碼器加分類頭。嵌入模型也用編碼器讀文字,但輸出代表語意的數字,用來比相似度。