文字描述進,一張圖片出
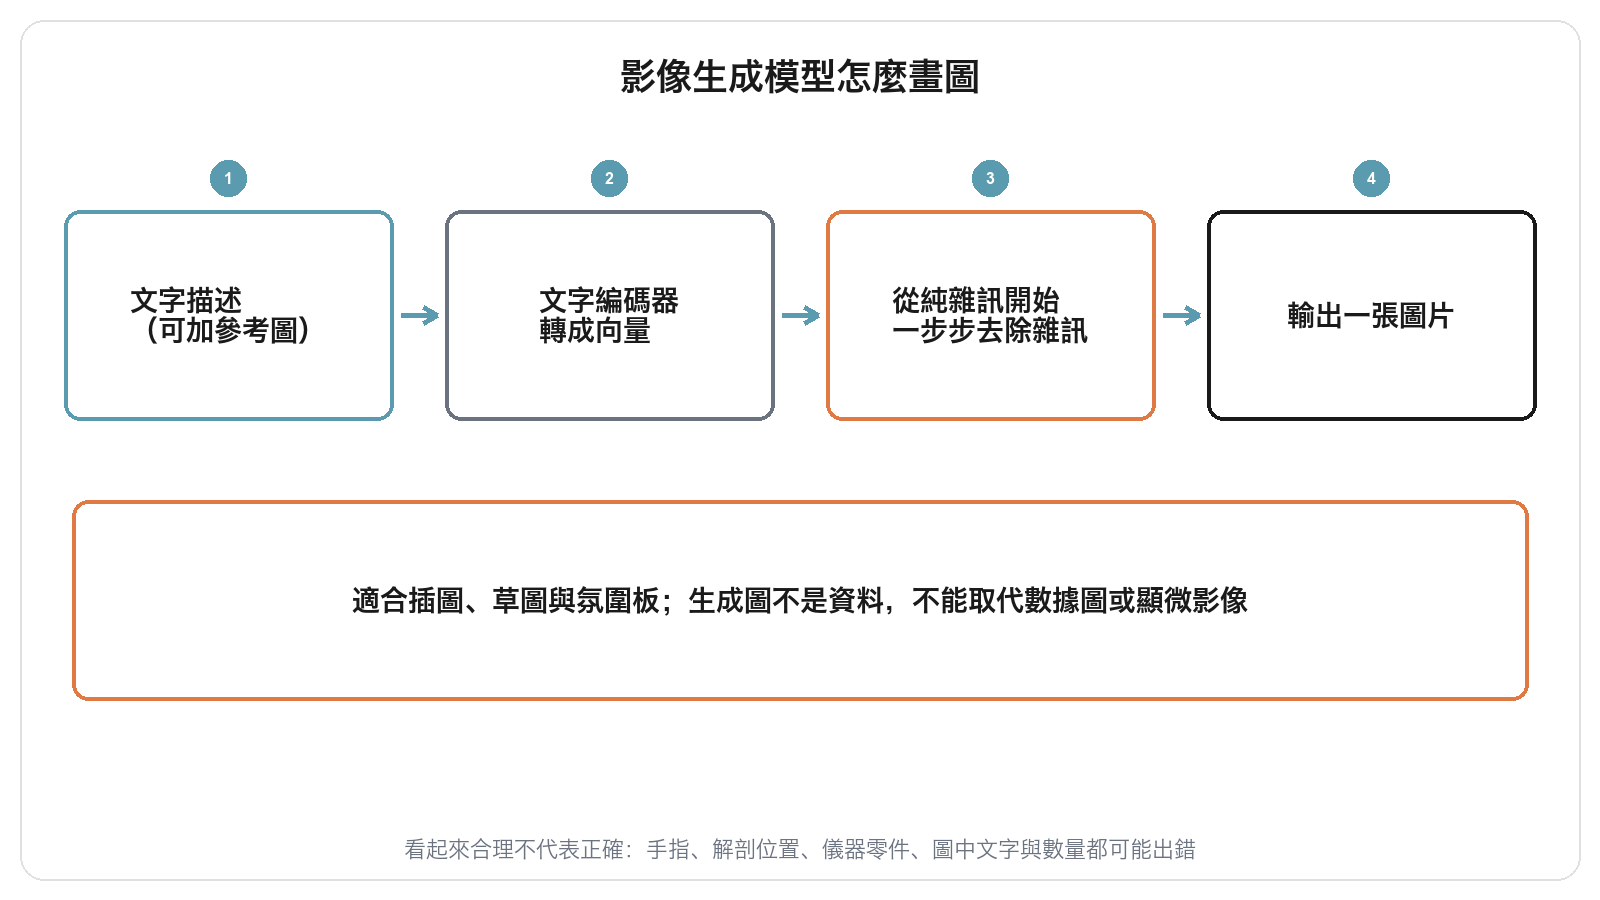
影像生成模型讀進一段文字描述,有時再加一張參考圖,輸出一張新的圖片。
想像一下,你要替一篇談睡眠的文章配封面,只要描述「深夜的城市,只剩幾扇窗亮著」,它就能生出幾種構圖。為什麼這樣的圖不能當研究資料?要從它怎麼畫圖說起。在AI 模型種類地圖上,它和視覺語言模型方向相反。
擴散模型:學會一步步去除雜訊
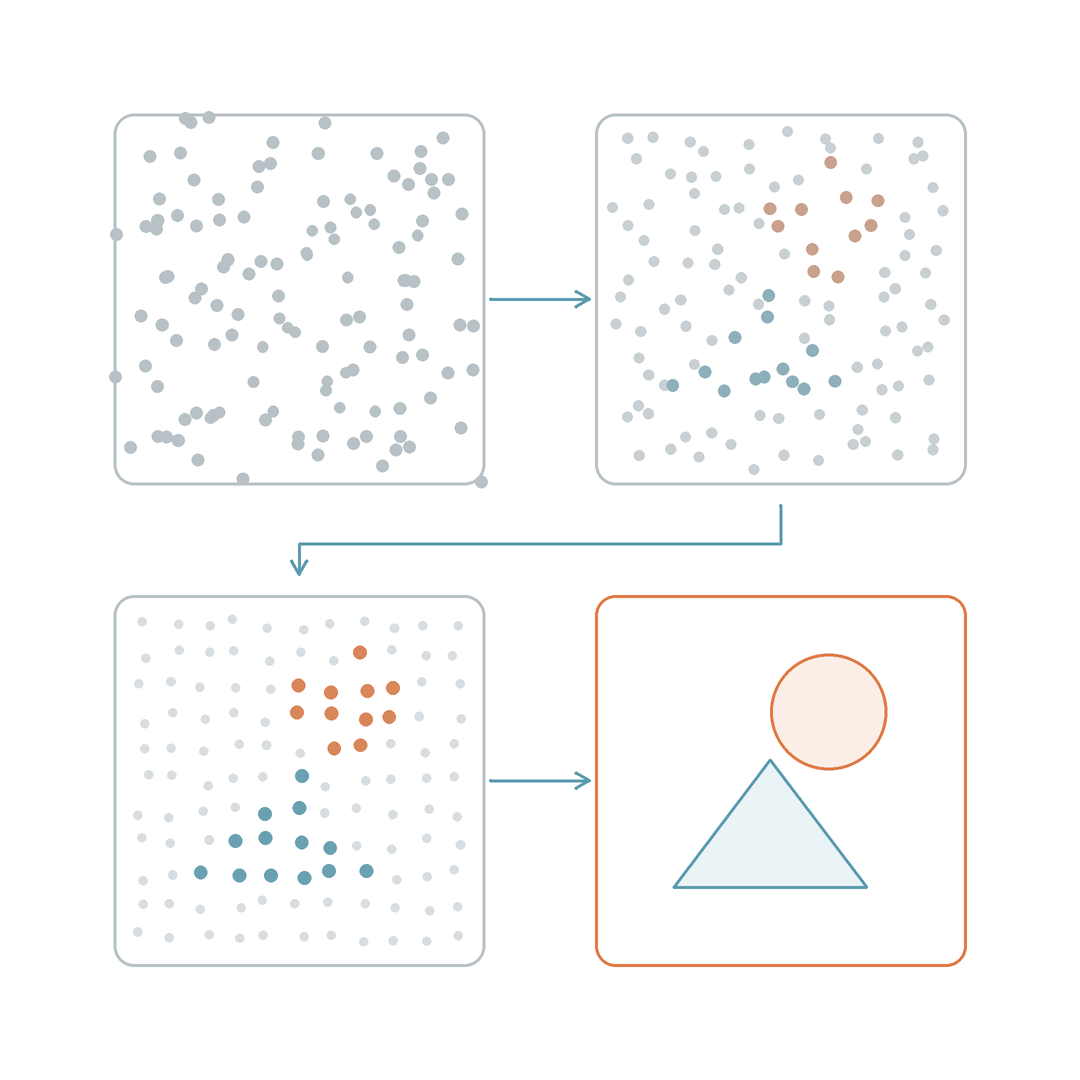
目前主流的影像生成模型是擴散模型,它在訓練時只練一件事:把加了雜訊的圖還原回去。
研究者在大量圖片上逐步加入隨機雜訊,直到畫面被打碎成一片雪花,再讓模型學著判斷帶雜訊的圖裡混進了哪些雜訊。Ho 等人 2020 年的 DDPM 論文把這套做法整理成穩定的訓練流程。生成時方向倒過來:模型從一張純雜訊開始,每一步擦掉一點,反覆許多步之後畫面才逐漸成形,就像在起霧的玻璃上慢慢擦出窗外的景物。
文字怎麼引導每一步
你寫的文字描述,負責替每一步去雜訊指方向。
模型怎麼知道該往哪裡擦?描述先經過文字編碼器轉成一串數字向量,模型去雜訊時參考這串向量,決定要往「一隻貓」還是「一座橋」的方向擦。CLIP 用大量網路圖文配對訓練,讓圖片和描述落在同一個向量空間,它屬於地圖上的嵌入模型。Ramesh 等人 2022 年的方法先由文字產生 CLIP 的圖片向量,再從這個向量畫出圖。Rombach 等人提出的潛在擴散則把去雜訊搬到壓縮後的空間:先用自動編碼器把圖片壓成小得多的表示,在那裡去雜訊,最後還原成完整圖片。原本會吃掉的大量運算因此省下,許多開源繪圖工具都建立在這個做法上。
適合做什麼:插圖、草圖、氛圍板
它擅長把模糊的想法很快變成可以討論的畫面,例如文章插圖、概念草圖、氛圍板(mood board)與封面。
如同開頭的封面例子,你先生出幾種構圖,挑定方向再修。這類用途在意畫面傳達的感覺,細節是否與現實一致並不影響使用。
會出錯的地方:看起來合理,不代表正確
模型學到的是圖片通常長什麼樣子,但它不會檢查畫面是否符合事實。
這正是它的限制。常見錯誤包括手指數目不對、解剖位置錯置、儀器零件實際上裝不起來、圖中文字變成亂碼,以及要求畫 5 個物件卻出現 4 個或 6 個。所以生成圖不是資料。研究報告裡的數據圖、顯微影像、凝膠或染色照片,都必須來自真實的量測與拍攝,不能用生成圖代替或補足。你對外使用生成圖時,請標明它由 AI 生成,並保留使用的工具與描述,讀者才分得清哪些是示意、哪些是紀錄。
和鄰近模型怎麼分
要選哪一種,看你需要的是示意圖,還是能被核對的圖。