搜尋撈回一堆結果,真正該讀的常常不在最前面
你知道文獻搜尋的第一頁好不好用,常常就看重排序這一步嗎?
重排序模型(reranker)讀進一個問題和一小批已找到的候選,替每筆打相關分數,再依分數重排。在AI 模型種類地圖裡,它站在嵌入模型和大型語言模型中間。
輸入與輸出:一個問題加一批候選,換回一排分數
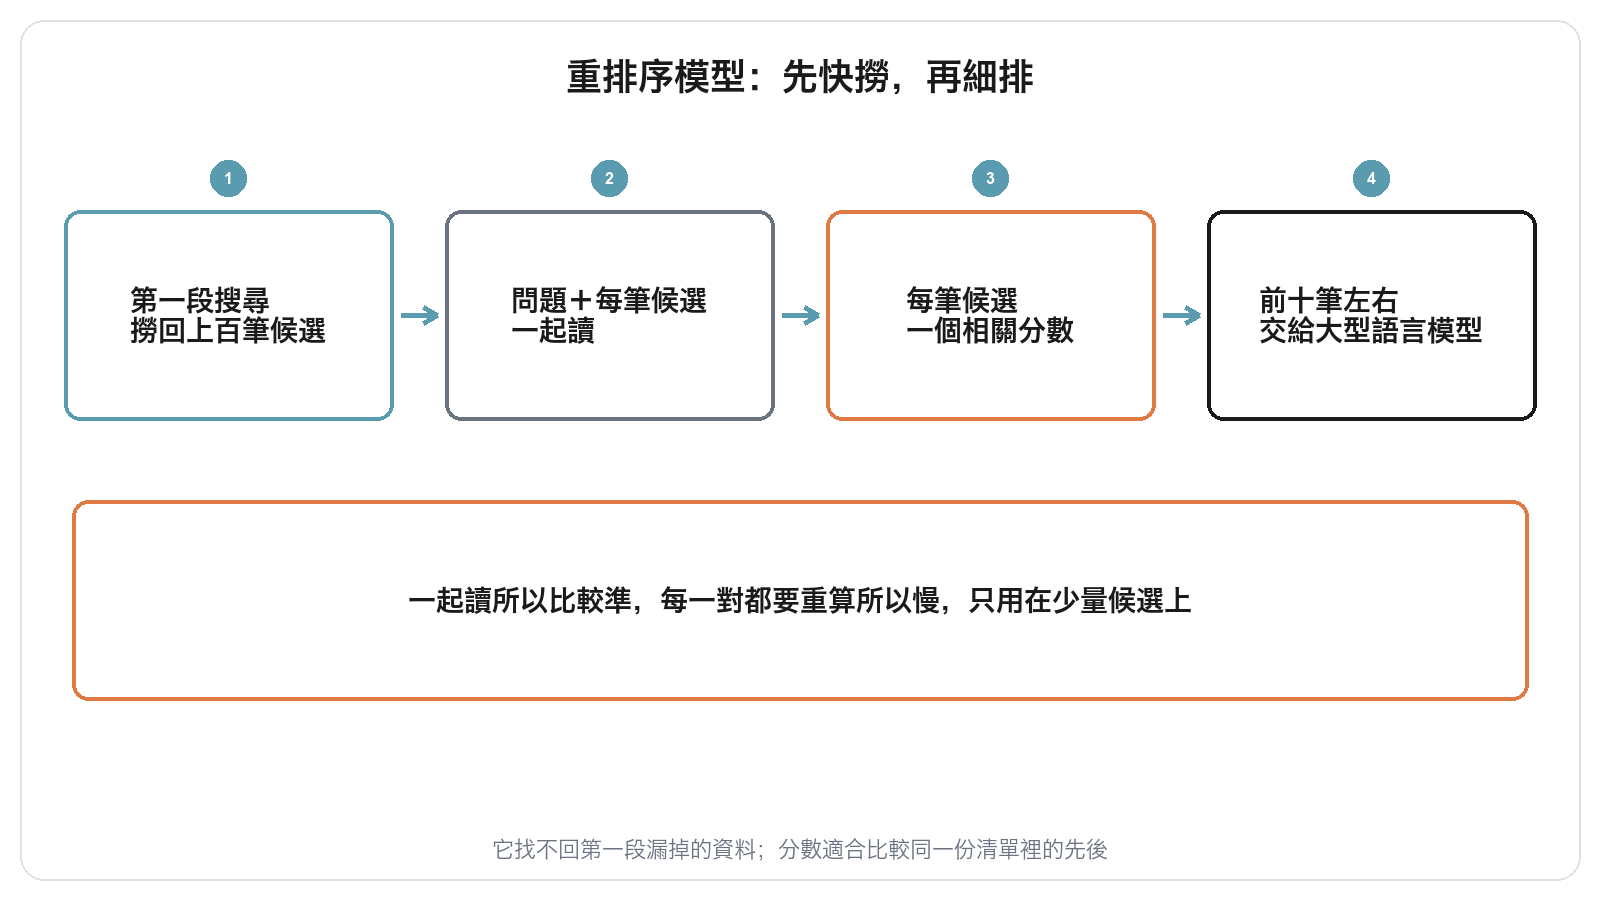
輸入是「問題+候選」的配對,輸出是每一對各一個分數。
假如你撈回 100 段文字,它就把問題和每一段一起讀、打分,共算 100 次。它只負責排序。它不寫句子,也不另找資料。
為什麼比較準:問題和候選放在一起讀
重排序模型屬於交叉編碼器(cross-encoder),把問題和候選接成一段交給同一個模型讀。
嵌入模型屬於雙編碼器(bi-encoder):問題和每份文件各自轉成向量,最後只比距離。文件向量可以事先算好,查詢很快,可是編碼文件時模型看不到問題。交叉編碼器每次同時看到兩邊,能注意到字詞對應、否定句和條件限制,就像面試官對照職缺需求細讀履歷。它不只比對關鍵字。
代價是速度。為什麼不直接拿它搜整個文件庫?Sentence-BERT 論文估算,在 1 萬個句子裡找最相似的一對,用 BERT 交叉編碼要算約 5,000 萬次、用掉約 65 小時,雙編碼器只要約 5 秒。所以它只用在少量候選上。
兩段式檢索:先快撈,再細排
常見做法是第一段用嵌入模型或關鍵字搜尋撈出上百筆,第二段讓重排序模型挑出前十筆左右。
這好比面試官只細讀通過初篩的履歷。Sentence Transformers 官方文件的範例,先用雙編碼器取回前 100 筆再用交叉編碼器重排。第一段也可以是 Karpukhin 等人的密集段落檢索(DPR);Nogueira 與 Cho 在 2019 年把 BERT 放在第二段重排段落。交給大型語言模型前這一步更要緊,因為段落若只沾到邊,模型可能拿不相干的內容湊答案。
例子:問一個文獻問題
假設你想查規律運動能不能改善老年人的睡眠品質。
第一段撈回的結果堆積了許多用詞相近的摘要:運動影響睡眠的動物實驗、失眠的綜述、其他介入方式的試驗。重排序模型逐篇和問題一起讀,通常會把真正在老年人身上量過睡眠品質的試驗往前移,只談機制或只做小鼠的往後放。
限制:算得慢、找不回漏掉的、分數只能比同一張清單
限制有三處:成本、漏撈,以及分數該怎麼解讀。
候選多一倍,吃掉的計算就多一倍。它只能重排第一段給的東西,第一段沒撈到的,要回頭改搜尋。分數適合比較同一份清單裡的先後,如同面試分數只適合比同一批應徵者。有些模型的分數落在 0 到 1 之間,看起來像機率,但換一個問題,同樣分數代表的相關程度可能不同,所以設固定門檻前,先拿你自己的資料檢查。
和鄰居怎麼分:嵌入模型、大型語言模型、決策模型
你要從大量文件找東西,用嵌入模型;已有一批候選要排準,用重排序模型;需要新寫答案,才交給大型語言模型。
決策模型也輸出分數。差別在分數打給誰:重排序模型替每次搜尋撈回的候選打分;決策模型替事先列好的固定選項打分,例如把摘要歸到幾個研究類型之一。原理見決策模型的原理與訓練,DecisionRAG 則示範讓決策模型逐層挑資料。