兩個方向:聽和說
想像一下,你把一小時的會議錄音交給手機,拿回逐字稿,再請它念出其中一段。
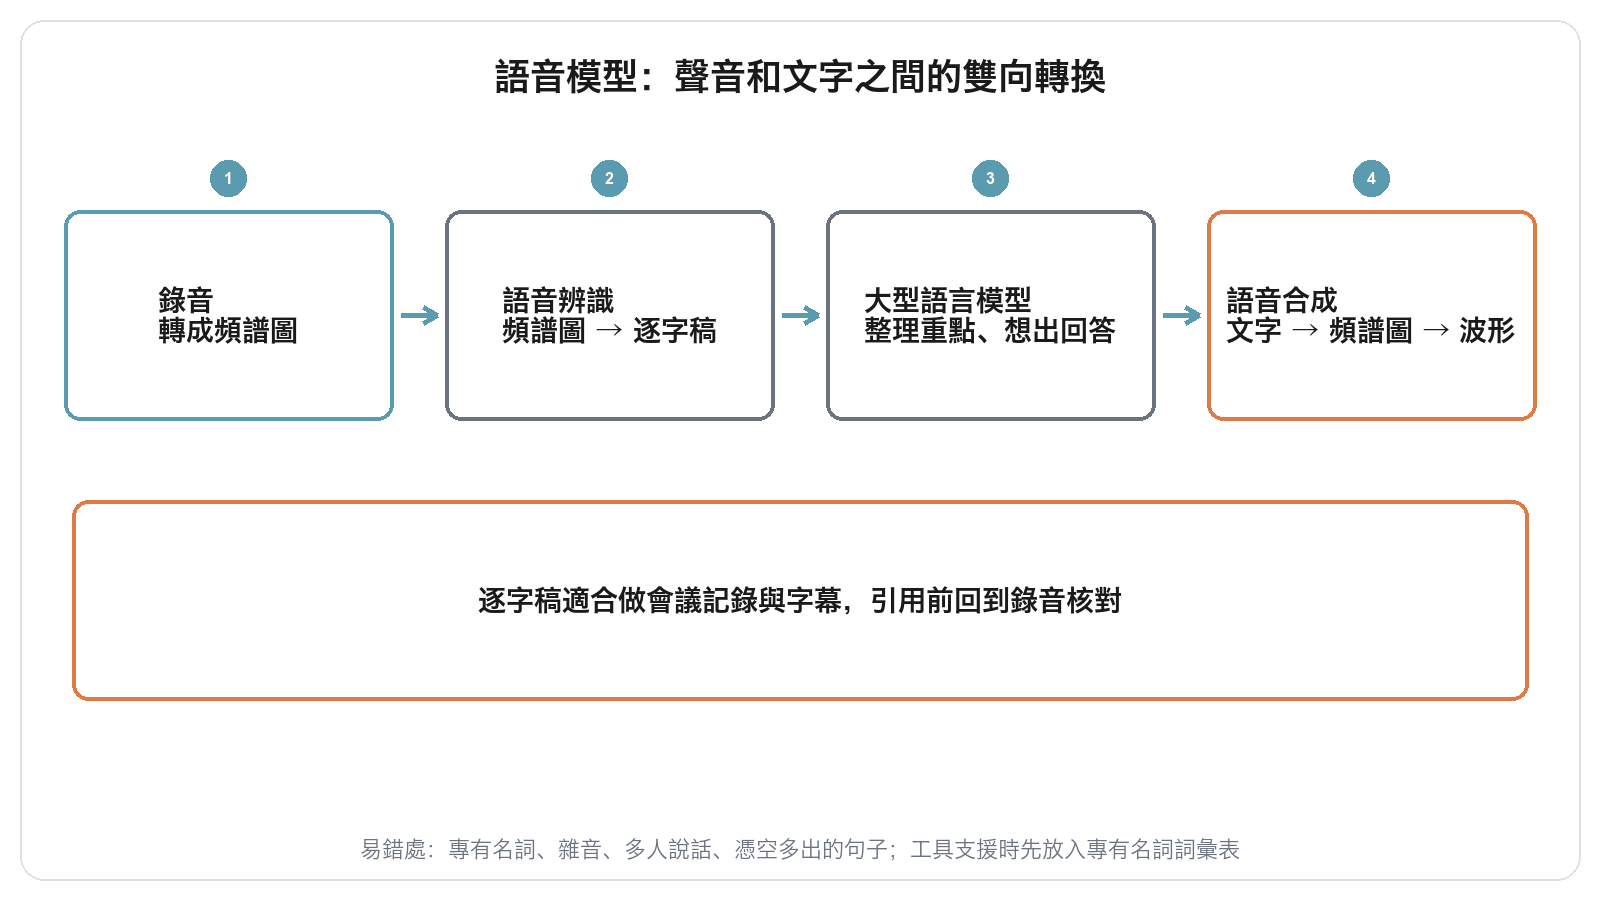
這兩步各由一種語音模型負責:語音辨識(ASR)讀進聲音,輸出逐字稿;語音合成(TTS)讀進文字,輸出念出來的聲音。你知道它們怎麼辦到的嗎?
在 AI 模型種類地圖上,語音模型負責聲音和文字之間的轉換,手機語音輸入、影片自動字幕和導航報路聲都靠它。
語音辨識怎麼運作
語音辨識先把聲音轉成一張頻譜圖:橫軸是時間,縱軸是頻率,顏色深淺代表各頻率有多強。
頻譜圖就像一份樂譜,模型讀譜後逐段寫出文字。以 Whisper 為例,研究團隊從網路收集約 68 萬小時「音訊配逐字稿」資料訓練它,涵蓋多種語言,所以不必為單一情境重新訓練,也能處理不同口音與錄音品質。不過它學到的是哪種聲音圖樣常對應哪些字,所以輸出的是最可能的文字,未必和原音一字不差。
語音合成怎麼運作
語音合成走反方向:文字先變成頻譜圖,再變成可以播放的波形。
Tacotron 2 是常見的例子,分成兩段。第一段模型讀文字,預測對應的頻譜圖;第二段是聲碼器(vocoder),把頻譜圖轉成一個個聲音取樣點,就像樂手照著樂譜演奏。它用的聲碼器是改良過的 WaveNet,一種逐點產生波形的模型。語音助理常把三類模型串在一起:語音辨識聽懂你說的話,大型語言模型想出回答,語音合成再念出來。
適合做什麼
語音辨識適合把堆積的口說內容變成可搜尋、可編輯的文字,例如會議記錄、訪談逐字稿和影片字幕。
一小時的研究會議錄音先轉成逐字稿,再交給大型語言模型整理重點,你只需要校對,省下重聽錄音用掉的時間。語音合成適合把文字念出來,例如替視障讀者朗讀網頁,或替長文產生有聲版本。
容易出錯的地方
為什麼專有名詞最容易出錯?因為藥名、基因名、人名在訓練資料裡出現得少,模型容易聽成發音相近的常見詞。
口音重、背景雜音吃掉部分字音,或幾個人同時說話時,錯誤也會變多。逐字稿不會標出每句話是誰說的,要分出講者得另做一步語者分段(speaker diarization)。工具支援自訂詞彙表時,先放進會出現的專有名詞;OpenAI 的語音轉文字文件也建議用提示改善名稱、縮寫和專業詞彙的辨識。
語音辨識還可能寫出通順、錄音裡卻沒有的句子。Koenecke 等人 2024 年發表的研究分析了 Whisper 的逐字稿,發現約 1% 含有整句憑空出現的內容,停頓較長的錄音更常發生。這項研究也有限制:它測的是當時的版本,之後版本的比例可能不同。所以引用逐字稿前,要先回到錄音核對。語音合成也能模仿特定人的聲音,使用前要先取得本人同意。
和其他模型的分工
拿到逐字稿之後的工作,通常交給別類模型。
要摘要或改寫,交給大型語言模型;要替每段逐字稿貼上固定標籤,例如「決議」「待辦」,或從中圈出藥名,編碼器分類與序列標註模型更快,也更便宜。視覺語言模型如同語音模型,把非文字的輸入帶進文字,只是它的入口是圖片。先看你手上的資料:如果是錄音,第一步就是語音辨識。