這幾天若在 X、開發者社群或各類 Agent 工具鏈的更新公告中反覆看到 Jev 與 TypeSafe.ai,多半不是因為它又寫出了文情並茂的長篇大作,而是因為它刻意反其道而行:它幾乎不寫文字,專門替軟體執行「快速、狹窄、便於串接」的判斷。[1][5]
核心本質十分明確:Jev 不是聊天機器人,而是供程式呼叫的語義決策引擎。 開發者將當前狀態(state)與一組固定型別的問題傳入,它便回傳具體選項、分數以及模型預估的機率;後續程式再依此決定分流、加權、呈報人工覆核,或轉交給體積更大的 LLM 處理。[1][3]
它到底是什麼?
TypeSafe AI 將 Jev 定位為首個公開運作的 System One model。[3][6] 該命名借鑑了卡尼曼(Daniel Kahneman)在《快思慢想》中提出的 System 1 概念:偏向高速、直覺,專門處理「數秒內即可下達的判斷」;相對的,則是目前主流 LLM 逐字輸出 token、步調偏慢、強調逐步深思的 System 2 風格。[3][5]
公司創辦人 Diogo Almeida 於發表文章中指出:生成式對話模型發展已臻成熟,但面對大規模自動化系統時,中間仍缺少一塊關鍵拼圖。TypeSafe 歷經約兩年隱形研發(stealth),重新設計底層架構、平行採樣器(sampler),並引入一套名為 RLCD(Reinforcement Learning for Calibrated Decisions) 的訓練目標:優化核心不在於「產生讓人讀來順暢的句子」,而是產出「能受軟體控制流信賴的校準決策」。[5][13]
模型名稱 Jev 則向 19 世紀英國經濟學家 William Stanley Jevons 致敬。Jevons 悖論的核心概念在於:資源使用效率大幅提升後,總消耗量往往不減反增,因為更低廉的門檻會催生出龐大的新應用場景。TypeSafe 的策略布局正是賭在這一點:一旦「單次具實用意義的 AI 判斷」延遲夠低、費用夠便宜,開發者便會將其嵌入過去因成本效益考量而不可能呼叫 frontier LLM 的各類邊緣邏輯中。[15][9]
一次呼叫長什麼樣?
在標準設計下,API 請求主要包含兩個區塊:
- State:當前情境資訊。可為一段客服對話、工單內容搭配訂單歷史紀錄、Agent 執行工具後的傳回值,或是純粹的 JSON 結構化狀態。[1][3]
- Questions:一組預先定義好資料結構的問題。目前官方提供的核心 primitive 共有三種:[1][3]
| 問題型別 | 詢問目標 | 回傳結構 |
|---|---|---|
| Choice | 從固定清單中擇一 | 選中項目、各選項機率估計、confidence |
| Score | 依自訂量表進行評分 | 分數級距、各等級機率估計、confidence |
| Noul | 評估該陳述為真的機率 | 0 至 1 之間的機率估計值 |
多個問題可包裹在同一次 API 呼叫中,在底層針對同一份 state 進行平行、相互獨立的評估;依官方說法,多問數個問題幾乎不會拖慢整體的響應時間,亦不易因問題相互堆疊而產生脈絡衰退(context-rot)。[1]
其回傳內容並非自然語言段落,而是高度結構化的資料:
{
  "choice": "technical",
  "probabilities": { "billing": 0.08, "technical": 0.85, "sales": 0.07 },
  "confidence": 0.82
}
後端程式可直接透過 if / switch / route 讀取欄位並進行分流,無須再撰寫脆弱的 JSON 正則修復工具或解析重試邏輯。[1][8][16]
為什麼現在突然受到高度關注?
這波熱度主要源於三個工程與市場因素的交會:
1. Agent 系統真正消耗資源之處,往往在於「判斷」而非「生成」
在現代 Agent 迴圈中,大模型被大量呼叫的時機,其實是挑選下一個工具、確認是否需要重試、評估當前輸出品質、決定是否請求人類協助,或是判定任務是否終止。這些任務的答案空間多半有限且封閉,實務上卻常被迫耗費龐大成本調用擅長長文寫作的 frontier 模型。[7][10][16]
Jev 的定位正好切中此痛點:將「maker(創作、複雜規劃、程式碼修改)」保留給 LLM,而將「checker / router(判斷分類、路徑分流、邊界把關)」全面轉移至專用決策模型。[7][10]
2. 官方宣傳的數據指標極具衝擊力
TypeSafe 官方宣傳主打約 193.6× 更快、444.6× 更便宜(此為針對內部特定 System One 工作流程的對比測試)。[6] 依官方文件所列公開定價,輸入費用約為 $0.042 / 百萬 tokens(換算約 $42 / 十億 tokens),輸出 token 完全不計費;規格敘述中亦強調其延遲通常落在數十至數百毫秒的產品區間。[2][5][10]
必須強調的是:這類數據僅屬廠商宣傳上限與行銷數字,未經第三方獨立嚴格驗證,絕非各類專案的常態保證值。 發表文章與獨立技術評論均提醒:此類評估基準通常在極度貼近伺服器端的理想網路環境中量測,且測試案例由官方團隊量身打造;一旦更換對照基準,效能與成本倍數將大幅變動。部分技術評論者以定位更相近的輕量分類器重測後指出,實際優勢可能收斂至數十倍區間,而非宣傳所稱的數百倍。[5][10][15]
3. 開發者生態系迅速跟進整合
發表後數日內,多個主流開發者工具鏈便陸續釋出 pass-through 或閘道支援:LangChain 發布了 harness 整合指南,LiteLLM 納入 TypeSafe System One 的 pass-through(走專屬的 evaluate 端點而非 /chat/completions),Vercel 亦將 Jev 列入 AI Gateway 的更新支援清單。[7][8][17] 工具鏈的無縫銜接大幅降低了評估門檻,促使該概念迅速擴散至社群。
優點:專為軟體流程設計的「語義條件式」
優點 1:輸出格式天生可直接對接程式碼
回傳的答案空間全由呼叫端預先定義。TypeSafe 強調模型具備強結構約束,不會傳回超出定義範圍的型別或項目(例如限定四個服務部門,模型絕不會憑空創造第五個)。[5] 對後端系統或 Agent 框架而言,這比起仰賴提示詞要求「請僅以 JSON 回覆」再套上多層驗證,更符合原生控制流的設計原則。[1][16]
然而,這裡存在一個極易被簡化標題誤導的關鍵界線:官方語境中的「Zero Hallucinations」,僅指輸出結果嚴格符合 schema 結構定義,絕不代表業務選擇保證正確。 系統依然可能將 technical 工單誤判歸類為 billing;其差異僅在於它絕不會回傳未定義的 billing. 或一段「這看起來偏向帳務問題……」的無效字串。[5][16]
優點 2:機率與 confidence 成為一等公民
每次決策皆附帶機率分布;Choice 與 Score 亦提供 confidence 欄位,可作為程式碼判斷「是否放行自動執行」的輔助維度。[1][12] 這使工程團隊得以建立分層防禦機制:
- confidence 偏高 → 系統直接分流執行
- 落入中間模糊帶 → 觸發補充提問或調度大型模型二次確認
- confidence 偏低或涉及重大操作 → 強制呈報人工覆核
需特別釐清:回傳的機率欄位僅是模型的統計估計值,絕不可直接作為安全授權或存取控制的單一依據。 官方技術文件亦清楚說明:校準度衡量的是長期預測結果的統計頻率,並非單次推論正確性的絕對保證。[3][13]
優點 3:支援多題平行評估,適合多維度狀態檢查
針對同一份客服工單,系統可在單次請求中同時詢問:緊急程度、歸屬部門、使用者挫折指數、是否涉及退款申請。各問題由底層平行計算,再交由程式碼進行邏輯加權,無須硬將所有判斷面向塞入單一巨型 prompt 要求模型統整輸出。[1][14] 此特徵高度契合複合評分(composite scoring)、意圖路由(intent routing)與推測性展開(speculative fan-out)等架構模式。[14]
優點 4:計費與延遲結構利於高頻率輕量判斷
僅計算輸入 token 費用、輸出免費、底層平行處理且不產出長篇文字:若業務情境涉及每秒大量請求的分類、打分或 guardrail 檢核,此類模型的單位經濟效益與反應速度,將顯著優於每次調用大型推論模型再手動剖析文字的做法。[2][5][7]
優點 5:業務規則收斂於程式碼,避免提示詞過度膨脹
官方倡導的架構哲學為:將複雜決策拆解為細緻的原子問題,並在程式碼中進行最終邏輯組合。[1] 當權重配置、臨界門檻或合規策略調整時,工程師僅需修改程式邏輯與參數,無須頻繁改寫語義邊界容易漂移的巨型自然語言 prompt。[14][15]
缺點與限制:狹窄的定位既是特色,也是邊界
缺點 1:無法產出文字、不具備解釋能力、無法執行多步規劃
Jev 完全不生成對話文字、不撰寫程式碼,亦不產出逐步推理過程。[3][5] 凡涉及撰寫回信、文獻摘要、程式重構或發散性腦力激盪之任務,Jev 均不適用。實務上的標準架構應為 LLM + Jev + 決定性程式邏輯 + 人工覆核,而非將其誤用為通用 LLM 的替代品。[15][16]
缺點 2:輸入格式目前僅支援純文字
公開模型規格明確限制為:僅支援純文字(text),包含一般字串、JSON 物件或字串陣列。[2][3] 若有影像、音訊或視訊等多模態資料,必須預先於前端轉譯為文字特徵或結構化欄位,方可傳入 state 進行評估。
缺點 3:英文表現最佳;中日韓語系表現需自行實測
官方文件坦率指出:訓練資料集以英文為主,英文任務的準確度與校準表現最佳;涵蓋中日韓(CJK)在內的其他語系雖有支援,但表現未達同等水準。各團隊在將非英文工作負載推向生產環境前,必須自行進行基準測試,並設定更保守的 confidence 門檻來約束自動化行為。[2]
對繁體中文使用情境而言,這一點尤為關鍵:在地化客服對話、企業內部中文工單或具專業門檻的醫療法規語料,絕不可直接套用英文公開評測數據作為品質背書。
缺點 4:上下文視窗與題目設計存在嚴格物理邊界
目前公開的規格邊界為:單次請求總長度上限約為 64k tokens;其中 state 內容搭配最長單一問題的長度上限約為 32k。[2] 問題必須維持「原子化」,定義情境應落在專業人員數秒內即可裁決的範疇;若問題涉及多重因果糾纏或長鏈推理,應在架構層拆解為多個子問題,再於程式碼端整合,而非強行包裝成複雜的開放式申論題。[1]
此外,Choice 的選項基數亦存在實務上限(社群文件普遍建議在 255 個選項以內;超出此範圍可能需走分段比對,延遲將顯著上升)。[16] 面對超高基數分類或動態標籤探索,此架構並不具備優勢。
缺點 5:不支援客戶端自訂微調,專屬適配仰賴請求設計
官方明確規範:Jev 不提供客戶端資料微調(Fine-tuning)或 LoRA 訓練服務,所有租戶共用同一套底層權重。若需適配專屬領域,團隊需將特定背景知識置於 state、將判斷準則寫入 instructions 與 criteria,或將拆解後的原子輸出作為機率特徵,交由下游的傳統機器學習模型做進一步判讀。[2]
缺點 6:底層訓練細節尚未公開,生態系處於早期存取階段
RLCD 機制的數學細節、平行採樣器的實作原理與整體神經網路架構,官方至今未釋出完整論文級的技術報告;其宣稱的校準度能否在各團隊的自有資料分布上成立,完全取決於自建測試集的實測結果。[13][16] 此外,在服務初期其 rate limit 仍會動態變動,直接存取 API key 可能需排入等候名單(waitlist),實務評估初期多半需透過閘道或代理服務進行測試。[2][8][16]
缺點 7:單一判斷各自校準,不等於組合後的管線維持校準
此為系統整合層面常見的盲點:個別問題即使統計校準度良好,但在系統中套上 0.7 或 0.9 等人為設定的切分門檻並經由權重公式相加後,整條工作流的端到端錯誤率與不確定性將會被重新塑形。獨立技術評論亦特別點出:單點決策的校準性,並不等同於複合工作流的端到端校準性。[16]
缺點 8:與通用 LLM 結構化輸出的邊界易被宣傳修辭模糊
當前主流大型模型亦已廣泛支援嚴格 schema 約束與結構化輸出(structured outputs)。Jev 所主打的差異化價值,核心在於專為決策打造的原生介面、校準機率估計、極低延遲與計費優勢,以及多題平行評估,並非單純「具備合法 enum 輸出能力」這一點。[16] 若系統每天僅需執行數百次判斷且既有的結構化輸出表現穩定,更換基礎架構的投資報酬率,恐不如針對 Agent 迴圈內每日上萬次 checker 呼叫進行重構來得顯著。
實際應用邊界盤點(基於 2026-09 現狀)
綜合整理官方 use-case map、架構 patterns 以及社群生態系文章,目前 Jev 較具可行性的落地情境如下:[4][7][14][15]
A. 自動化系統中的語義決策層
- 客服與 ITSM 流程:部門分流、緊急度判定、退款資格初篩、是否升級真人
- CRM 與業務工單:客訴意圖識別、處理優先級排定、潛在客戶評分(lead scoring)
- 內容合規審核:針對預設違規政策進行標記、打分或合規判定
- 維運監控告警:嚴重級別判定、標準作業處置程序(playbook)挑選、通報層級確認
此類場景具備高度一致的特徵:決策集合預先封閉明確、呼叫頻率極高,且必須具備降級至人工覆核或傳統規則引擎的安全退路。
B. Agent Harness:意圖分流、防護把關與終止條件裁決
LangChain 等整合研究將 Jev 部署於 Agent harness 架構內部:專門負責工具與子代理挑選、下一步行動判定(continue / retry / ask user / halt)、敏感操作前的風險評級,以及最終產出之格式與業務邏輯驗證。[7][16]
官方案例地圖亦明確納入 Harness Engineering 領域:涵蓋模型動態分流、語義檢索前處理、LLM 錯誤輸出攔截、推理軌跡(reasoning trace)分類等。[4]
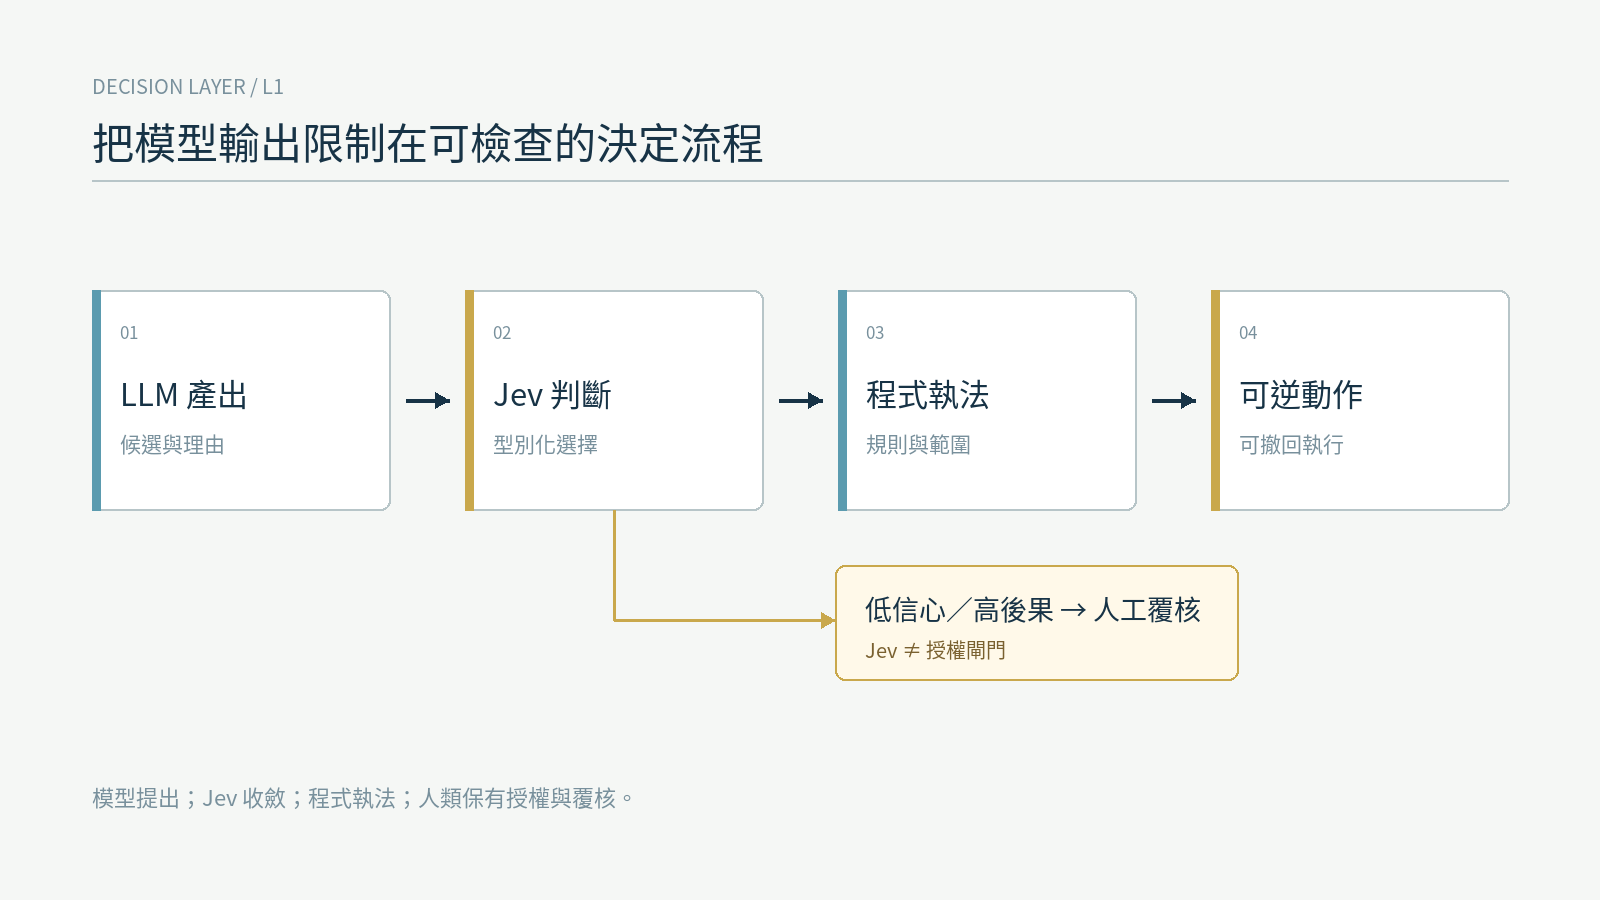
實務架構可歸納為清晰的分工法則:
LLM 負責產出;Jev 負責在關鍵節點表決分流;程式碼負責執行控制;人類負責高風險例外。
C. 針對其他 AI 生成結果的輕量驗證器
官方定義之 Universal Verification 模式:專門檢驗提示詞品質、抽取欄位是否完整、工具呼叫參數合理性、引用佐證是否具備說服力,或是否存在越獄(jailbreak)與幻覺前兆。由於此類檢查無需重新生成文字,其調用成本遠低於再呼叫一次同等量級的生成模型。[4]
這對於「生成成本高昂、但把關檢核需高度密集」的系統架構極具實務價值。
D. 大規模批次處理與資料層語義分析
當單次推理成本大幅下降,系統方能負擔對巨量資料進行語義處理:文件相關性評分、重排(rerank)、大量 Agent 軌跡歸類,或提取語義機率特徵作為傳統機器學習模型的輸入變數。[4]
社群中亦出現於 SQL 資料管線內針對特定欄位進行批次語義過濾與評分的實驗性案例,其本質仍屬於高通量、有限類別的確定性評估。
E. 高即時性互動與介面內嵌決策
官方將其百毫秒級別的響應能力歸納為即時互動類別:包含遊戲環境邏輯、介面動態決策等對使用者體感延遲極度敏感的場景。[4][5] 發表期間展示的 Doom 操作示範之所以引發關注,核心不在於 Jev 能否「理解劇情」,而是證實了確定性程式碼搭配高速決策模型,能夠在過去傳統 LLM 延遲完全無法負荷的即時迴圈中運作。[5][16]
F. 知識檢索與研究流程的篩選輔助
官方參考範例包含:醫學或學術系統性文獻回顧的納入/排除條件審查、質性訪談內容之預設主題標記、引用引文是否充分支持特定論點、研究方法學要素是否缺漏等。[4]
需嚴正釐清:Jev 在此類流程中僅扮演初階篩選與資料標記工具;文獻的深層詮釋、統計推論以及最終研究結論的確立,仍必須仰賴生成式模型、統計運算與人類研究員的專業判斷。
G. 搜尋增強(RAG)流程之後處理
透過評分(Score)或兩兩比對(pairwise comparison)評估 query 與檢索文檔之間的精準關聯度,進行重排(rerank)與上下文裁切,有效彌補向量嵌入(embedding)在粗篩階段語義精度不足的弱點。[4]
發表初期社群生態的三層分化
在模型釋出後的短時間內,圍繞 Jev 與 System One 概念的開源與社群專案迅速湧現。綜合檢視十餘個代表性專案,整體生態已具備明確的三層架構分工:[18]
- 官方託管服務與標準閘道端點:以 TypeSafe 官方託管 API(
POST /v1/systemone,如具體版本jev-1.13.0)為基礎架構,上游透過 LangChain、LiteLLM 與 Vercel AI Gateway 快速提供介面抽象,作為標準化的雲端決策端點。[1][7][8][17] - 本機開源類 Jev 基線(開放權重複製品):社群為降低對單一商業雲端 API 的依賴,展開多項本地推論嘗試。例如 SemIf(原 OpenJev)基於 4B 開源權重提供 option-logit 推論機制並完成 MLX 移植;[19] NanoJev 採用 0.6B 極小參數量搭配專屬訓練頭,專注探索無 decode 階段的純決策推論;[20] open-alternative-jev(so1)則展示在一般開源基礎權重上,透過單次 forward pass 讀取選項字母 logit 來模擬類 Jev 介面。[21] 儘管此類本機基線多處於概念驗證早期,但為敏感資料不離境的決策層實作提供了技術原型。
- 工作流應用端(應用程式與 Agent Harness):開發者將其決策介面實際接入具體系統中。例如 fast-jev-compaction 嘗試透過決策模型判定工具輸出片段之留存或截斷,避免自然語言摘要帶來的資訊失真;[22] jev-browser 與 jev-ultrafast 實作雙層架構:由 Jev 負責裁決動作與目標 DOM 節點,LLM 僅在需填入複雜文字時介入;[23][24] jev-search 實作以 Jev 挑選檢索源並執行重排,前端完全不產生生成式文字回應;[25] jev-sift 以 MCP 形式在讀取外部資源前實施批次過濾;[26] jev-security-scan 則結合靜態規則與 Jev 針對 Skill 與 MCP 設定檔進行合規排查;[27] 在 Agent 整合領域,pi-jev 與 hermes-jev-skills 則分別探索了將 Jev 作為工具呼叫守門員、輸出裁判或動態技能分流器的 harness 整合模式。[28][29]
社群目錄(如 awesome-jev-projects)所收錄的外部專案極為新穎,其執行期穩定性、面對惡意對抗輸入的防禦力以及生產環境安全性,絕大多數尚未經受完整獨立驗證(即普遍處於 verified=false 狀態)。理解此三層分工,有助於工程團隊在評估時精確辨識哪些屬於架構模式的演進,哪些仍屬實驗性質的概念原型。[18]
導入評估結論:採納決策層架構,但僅限受控試點推進
在確立了技術邊界與社群現狀後,我們評估可正式將 Jev 的決策層設計模式引進系統架構規劃中。然而,「採納架構模式」絕不等於直接在生產環境全面切換,更不代表將其視為完全成熟的解法。具體採行的推進原則包含:
- 嚴格採取受控、可回退的試點驗證:在導入初期全面實施 shadow-first(影子執行) 策略——讓 Jev 與現行既有流程平行運作,僅在背景記錄並比對其決策分布,不賦予其任何直接觸發寫入或不可逆操作的系統副作用。
- 強制釘選特定版本號:在 API 呼叫端明確鎖定具體版本(例如
jev-1.13.0),嚴格禁止依賴latest等動態標籤,以確保推論邏輯具備嚴格的重現性與稽核軌跡。[2] - 以代表性資料集實測核心指標:絕不採信宣傳層面的效能倍數,而是以內部具代表性的業務測試集為準,嚴格量測校準誤差(calibration error)、P95/P99 延遲、單案處置成本、人工升級率,以及假陽性與假陰性機率。
- 嚴密恪守資料邊界與授權底線:涉及法規機密、個人資料保護、核心專利或機密金鑰之流程,一律禁止外發至雲端託管 API。同時,Jev 本身絕非授權閘門,其傳回之機率數值僅屬模型統計推估,絕不能作為關鍵操作之權限核發依據,系統最終執行權必須保留於決定性程式碼與人工覆核層。
- 具備穩定數據累積後方推進下一步:系統接通 API 並不代表驗證成功。只有當受控試點在影子運作中累積了充足長度的監控數據、指標表現穩定且具備工程重現性後,團隊才會進一步評估小規模灰度放行,並梳理後續的工程實作細節。
決策評估矩陣:何時適用?何時應嚴格迴避?
| 業務情境特徵 | 建議因應策略 |
|---|---|
高頻率、選項範圍完全已知、結果直接注入 if 邏輯 |
適合評估 Jev 或採用「原子化問題 + 結構化決策」模式 |
| Agent 系統中存在大量 checker / router / guardrail 檢核點 | 建議優先實施 shadow 測試,通常具備最高的成本改善空間 |
| 需撰寫內文、產出程式碼、多步邏輯推理、開放式發散思考 | 應使用通用生成式 LLM;嚴禁指派給 Jev 處理 |
| 以繁體中文為主、高度依賴在地化術語與產業特定語料 | 可進行評估,但必須自建本地測試集並重新校正 confidence 門檻 |
| 每日決策量極低、現有 LLM 結構化輸出運作平穩 | 優先優化既有 prompt 與快取機制,無需承擔換用新模型的架構風險 |
| 醫療診斷、金融交易、權限控管等高風險自動化動作 | 僅能作為次要參考訊號;安全閾值、完整審計與人工覆核不可省略 |
務實的系統重構推進步驟:[10][15][16]
- 將現行系統中負責判定把關的 LLM prompt,全數拆解為獨立的原子問題(即便底層暫時沿用既有大型模型)。
- 選取具生產代表性的歷史樣本展開 shadow 驗證:使 Jev 與現行流程並行運算,禁止串接不可逆副作用。
- 評估維度嚴格覆蓋:統計校準度、真實響應延遲、單位成本變化、人工升級比例、假陽/假陰性率。
- 釘選特定模型版本(例如
jev-1.13.0),排除不可控的動態別名;待門檻依自有資料重新校正後,再行評估流量切換。[2]
架構視角下的本質認知
將 Jev 視為「現代版高效能分類器 API」或「具備語義理解能力的 switch 語法」皆有其道理,但仍未觸及核心本質。更具工程價值的詮釋為:
TypeSafe 與 Jev 正在確立一種軟體介面契約:機器智慧的形式不必然是對話框;它可以被包裝為純粹的函式——傳入狀態,回傳帶有不確定性評估的具型別決策。[1][5][13]
這種架構並未削弱生成式 LLM 的價值。它更像是將過去兩年間,工程團隊耗費大量心力透過 prompt 勉強約束出的「請只回答 YES/NO」或「嚴格輸出合法 JSON」等防禦性手段正式抽象為標準基礎設施,並在延遲、成本、平行查詢能力與機率校準上進行定向優化。在當前討論熱潮之下,真正應被落實的軟體工程準則甚至獨立於 Jev 這項產品之外:
凡是判斷結果需要直接接入系統控制流的節點,就不該向模型索求自然語言散文。
若 Jev 的表現經得起專案資料集的實測檢驗,系統將能以顯著更低的延遲與成本獲得具備型別保護的語義決策層;即便實測未能達標,重構過程中所梳理出的原子化問題結構與測試邏輯,亦能為系統留下更乾淨、更健全的控制架構。[16]
現階段技術規格速記
- 產品型號:TypeSafe AI 旗下之 Jev(System One),公開釘選版本如
jev-1.13.0;動態別名包含jev-latest與jev-preview。[2] - 通訊介面:輸入
state+ 具型別 questions → 輸出具型別 answers + probabilities(附加 confidence 指標)。[1] - 計費標準:輸入每百萬 tokens 約 $0.042,輸出 tokens 免費(以官方 models 頁面公告為準,可能隨服務進展動態調整)。[2]
- 已知邊界:純文字輸入、英文表現最佳、不提供客戶端微調、處於早期存取階段且配額受控、完全不生成文字內容。[2][3]
- 架構定位:自動化工作流與 Agent harness 內的決策與驗證中繼層,並非通用對話模型。[3][6]