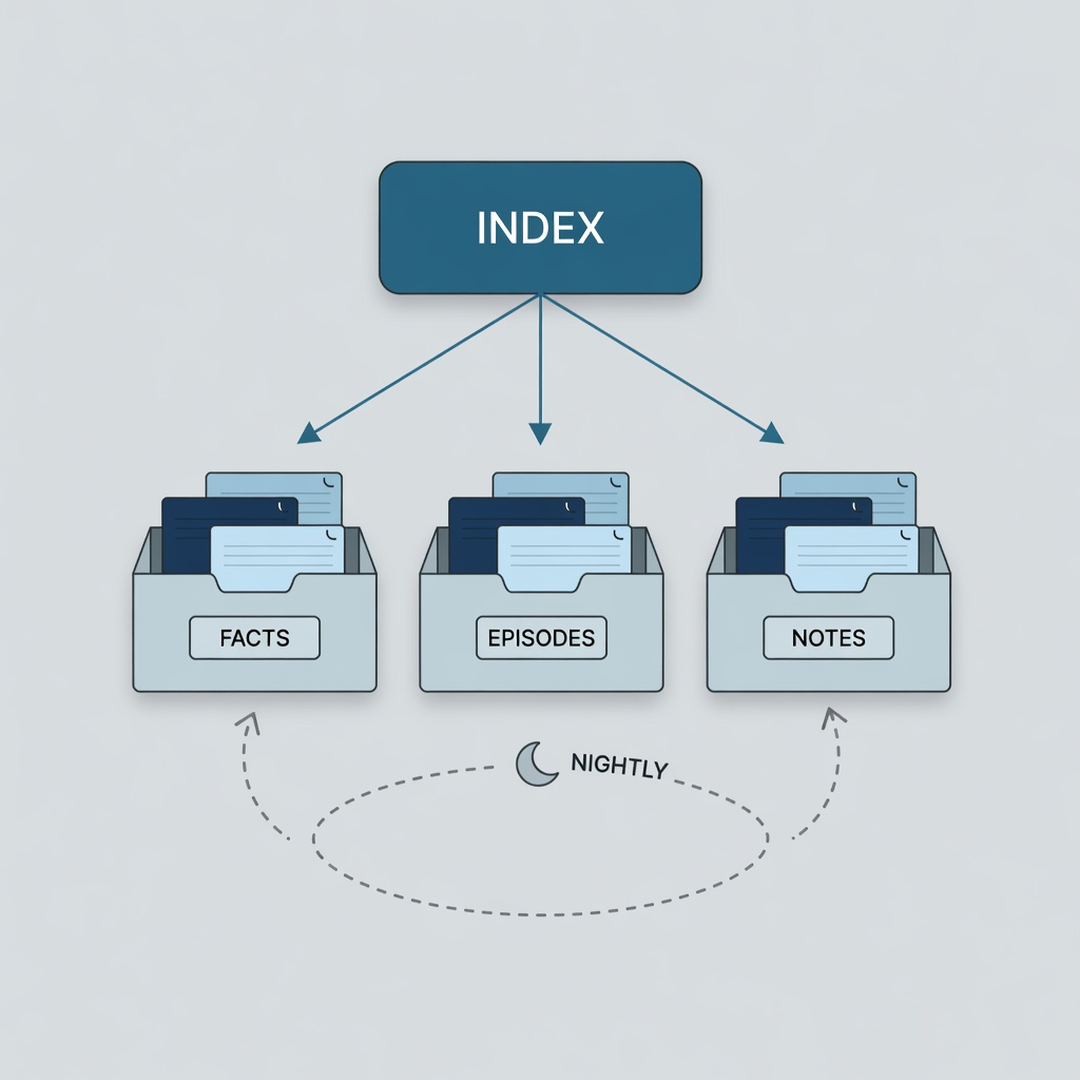
導讀:你的 AI 助理是不是明明記得上週的教訓,這週卻照樣重犯?我們依自己的使用需求設計了一套記憶系統,它不是業界標準做法;它的索引就像門牌,只負責在對的時候指路。這篇用六張圖說明它怎麼運作,以及我們為什麼這樣設計。
為什麼要自己設計一套記憶系統?
AI 記得住,卻不一定想得起來;這套記憶系統就是為了這個問題而設計的。
每一個 AI CLI 的 session 都從零開始。Ghost In Shell 是我們開源的本地記憶框架,替 Claude Code、Gemini CLI、Codex CLI 這類工具加上一層共用記憶。一年實際使用下來,我們累積了約 1,000 筆情節記憶與 570 多篇知識筆記,也發現一個問題:情節記憶裡清楚寫著「上週部署回報成功,但線上其實還是舊版」,AI 隔週照樣只看工具回報就宣告完成。
記錄存在,只是沒有在需要的那一刻出現。5.2 版把這一年的修正寫成程式。
**先說明定位:這是我們自己設計的做法,不一定與主流方案相同。**常見的 AI 記憶方案,多半把對話內容轉成向量後做語意檢索,或直接使用 AI 工具內建的記憶功能。我們走的是另一條路:記憶全部存成純文字檔(YAML、JSONL、Markdown),搜尋用關鍵字比對,再加上一份人工維護的觸發詞索引,不使用向量資料庫。這樣每一筆記憶都能被人直接讀、直接改,也能用版本控制追蹤。這個選擇有代價,文末會一併說明。
以下依序用圖說明。
圖一:三種角色
這套系統把記憶分成三種角色:索引指路、本體記內容、夜間整理負責維護。
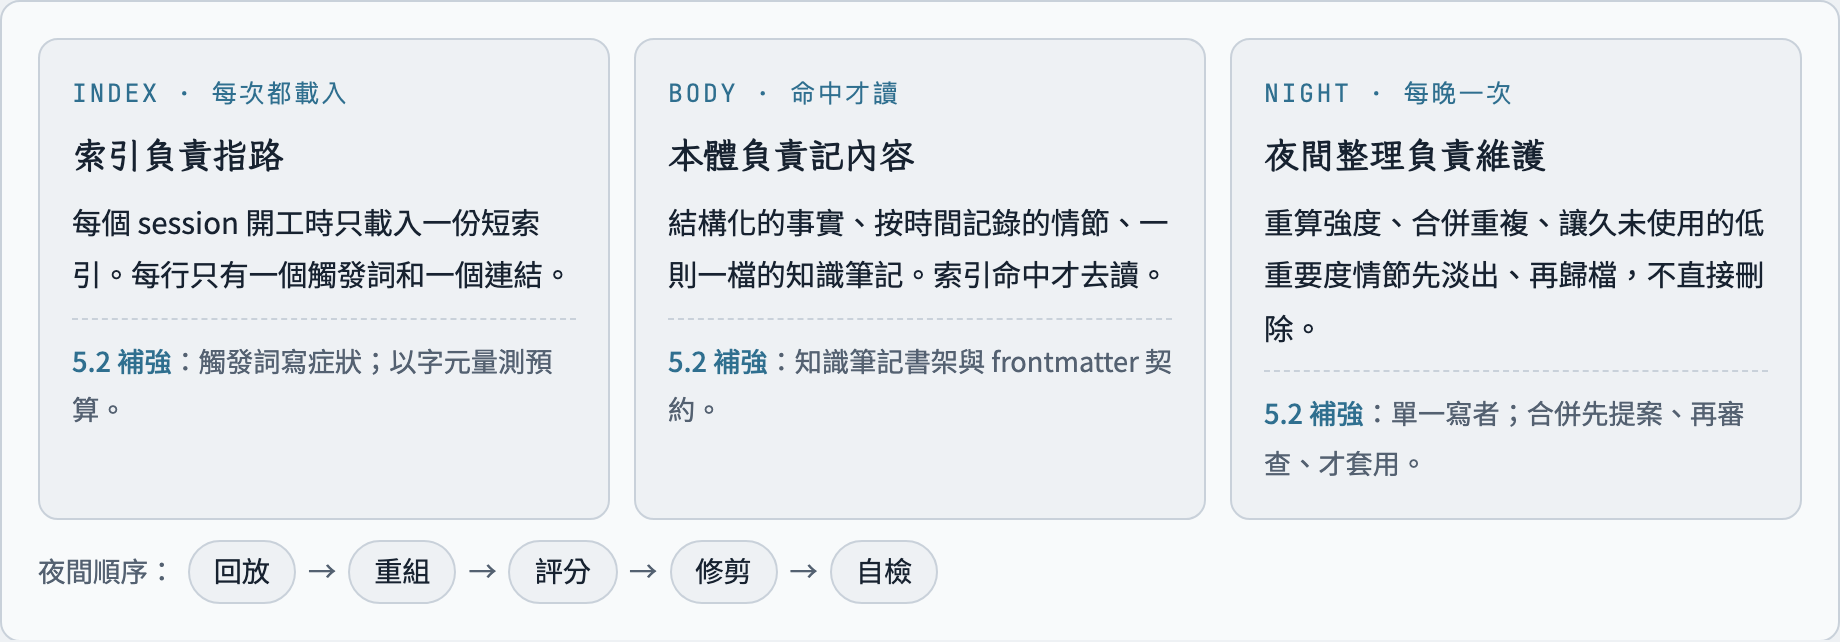
圖 1. 記憶系統的三種角色,以及 5.2 補強的位置。
- 索引負責指路:每個 session 開工時只載入一份短索引,每行只有一個觸發詞和一個連結。索引就像圖書館的門牌,本身不放內容。
- 本體負責記內容:結構化的事實、按時間記錄的情節、一則一檔的知識筆記,命中索引才去讀。
- 夜間整理負責維護:每晚依序回放、重組、評分、修剪、自檢。重要度低又久未使用的情節先淡出、再歸檔,不直接刪除。
上層只放指向下層的連結,不重複內容,所以同一件事只需要改一個地方。
圖二:觸發詞為什麼要寫成症狀?
觸發詞要寫成 AI 犯錯當下腦中的那句話,而不是寫成錯誤的成因。
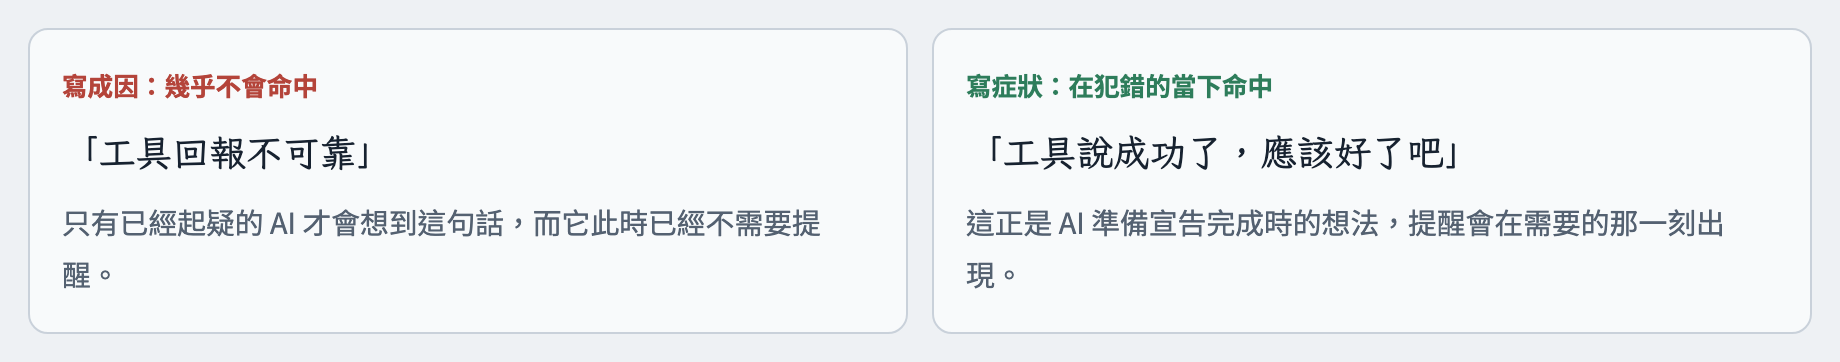
圖 2. 同一則提醒,兩種寫法的命中時機。
索引的每一行是一個觸發詞加一個連結。寫成因的那一行,只有已經起疑的 AI 才想得到,而它此時已經不需要提醒。寫成症狀,也就是 AI 犯錯當下腦中的那句話,提醒才會在需要的那一刻出現。
很多失效有兩個方向:閘門可能漏擋,也可能誤擋。兩個方向的症狀都要寫進索引,否則另一個方向永遠查不到答案。
圖三:啟動索引有字元預算
啟動索引超過大小上限時,尾段會被靜默截掉,所以要用字元數守住預算。
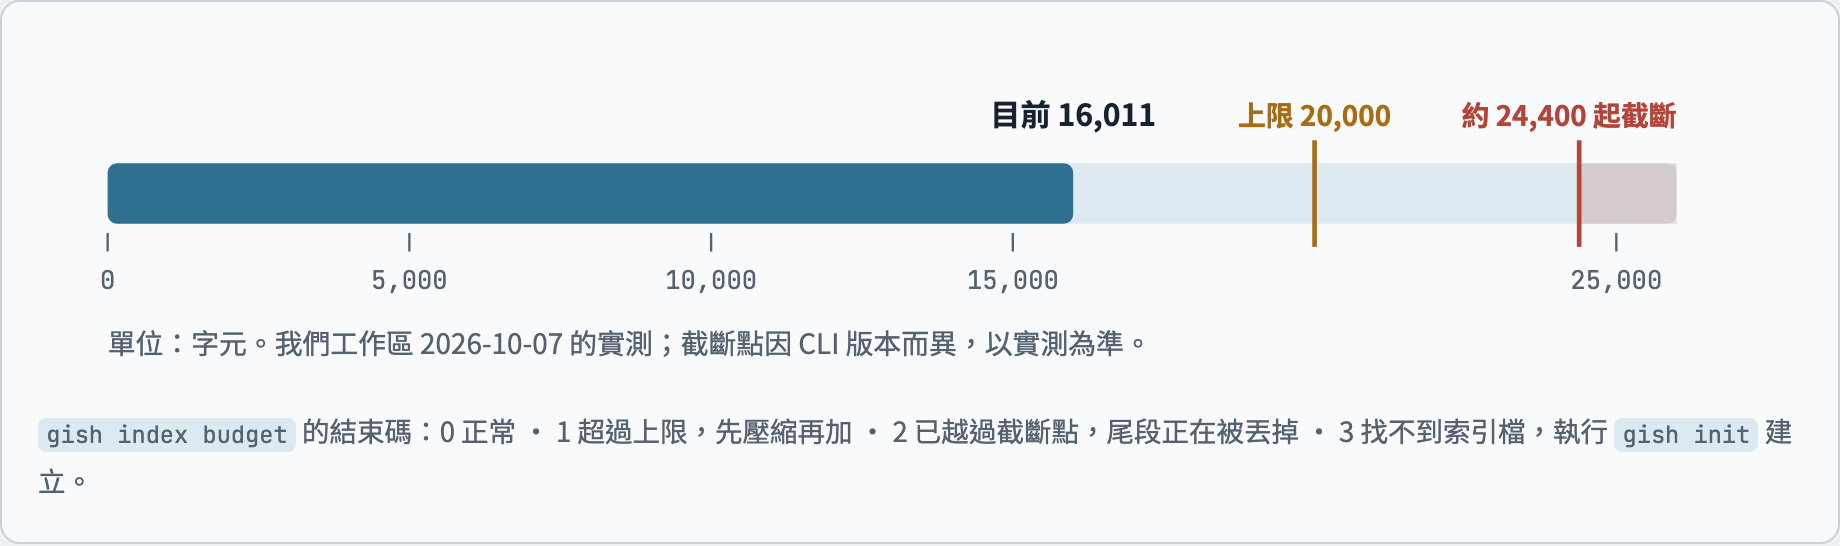
圖 3. 啟動索引的字元水位。作者工作區 2026-10-07 實測;截斷點因 CLI 版本而異,以實測為準。
每加一行索引,都會用掉每個 session 的一點載入預算。筆記越堆積越多,索引也跟著變長;我們用的 CLI 在啟動記憶檔超過一定大小後,超出的尾段會被直接吃掉,沒有任何警告。被丟掉的偏偏是最新加上的幾行。5.2 新增 gish index budget,以字元量測索引,因為中文與英文每個字的位元組數差很多,用位元組會量錯。
| 結束碼 | 意思 | 該做什麼 |
|---|---|---|
| 0 | 在上限內 | 可以加新的索引行 |
| 1 | 超過上限 | 先壓縮或把條目移到書架索引,再加 |
| 2 | 已越過截斷點 | 尾段正在被丟掉,立即處理 |
| 3 | 找不到索引檔 | 檢查工作區路徑,或執行 gish init 建立 |
圖四:兩層索引,以「會不會主動去查」分
索引分兩層,判準是 AI 會不會主動去查,而不是內容重不重要。
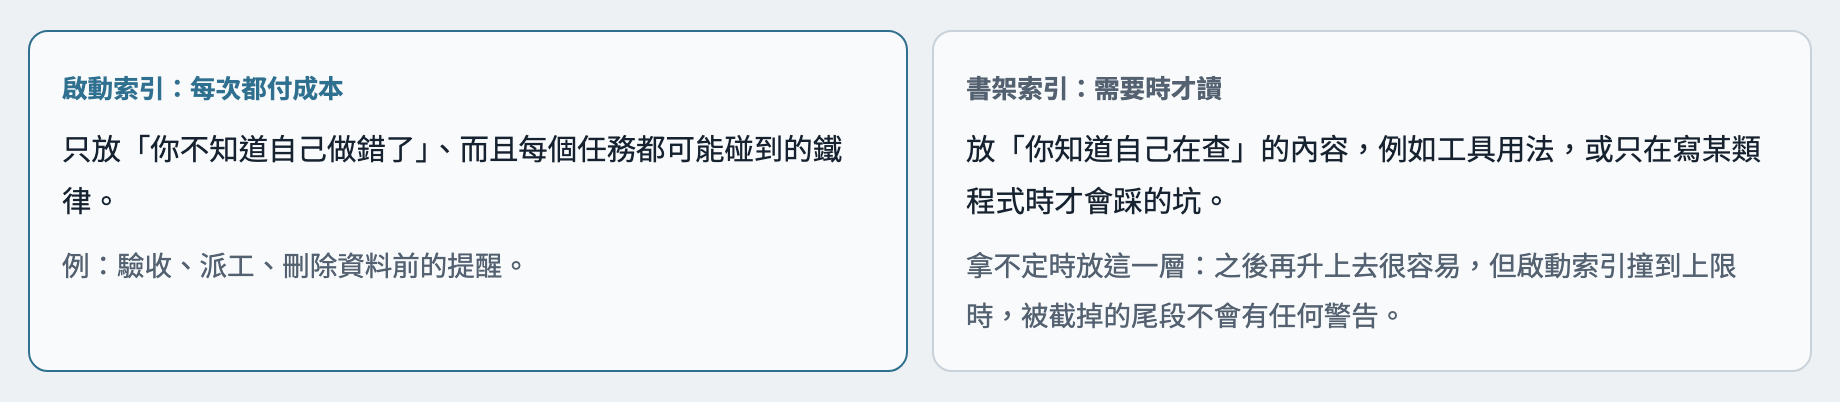
圖 4. 兩層索引的分工。
啟動索引好比隨身帶著的便條,書架索引則像放在辦公室的參考書。判準不是「重不重要」,而是「AI 會不會主動去查」。工具用法這類內容,AI 知道自己在查,放書架索引就好;驗收、派工、刪除資料前的提醒,AI 往往不知道自己正在犯錯,才需要每次都載入。拿不定時先放書架索引,因為之後再升上去很容易,撞到上限時被截掉的尾段卻不會有任何警告。
圖五:合併記憶要先提案、再審查、才套用
寫錯記憶比讀錯更危險,所以合併記憶要先提案、再審查、才套用。
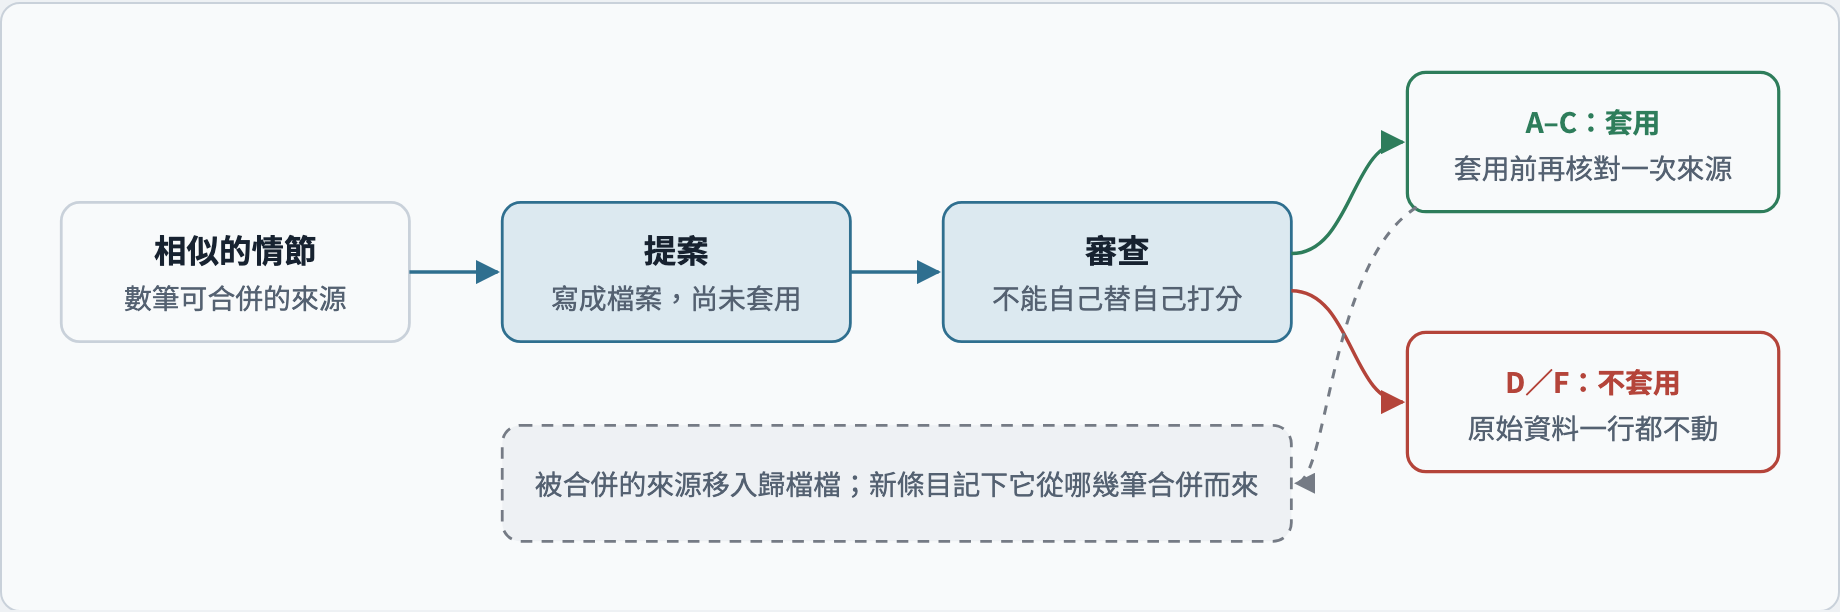
圖 5. 5.2 的整合流程:先提案、再審查、才套用。
讀錯記憶只影響一次回答;寫錯記憶,會影響之後每一個相信它的 session。5.2 的三條寫入規則:
- **只有一台主機寫入。**其他機器只能讀;機器角色存在本機設定,不放進會同步的資料夾。
- **先提案、再審查、才套用。**合併那一步不能自己替自己打分數;審查不通過,原始資料一行都不動。
- **不刪除,只歸檔。**被合併的原始記憶搬進歸檔檔,新條目記下它從哪幾筆合併而來。
圖六:索引裡沒有一篇是零命中
量測 301 個 session 後,索引指向的 59 篇筆記沒有一篇是零命中。
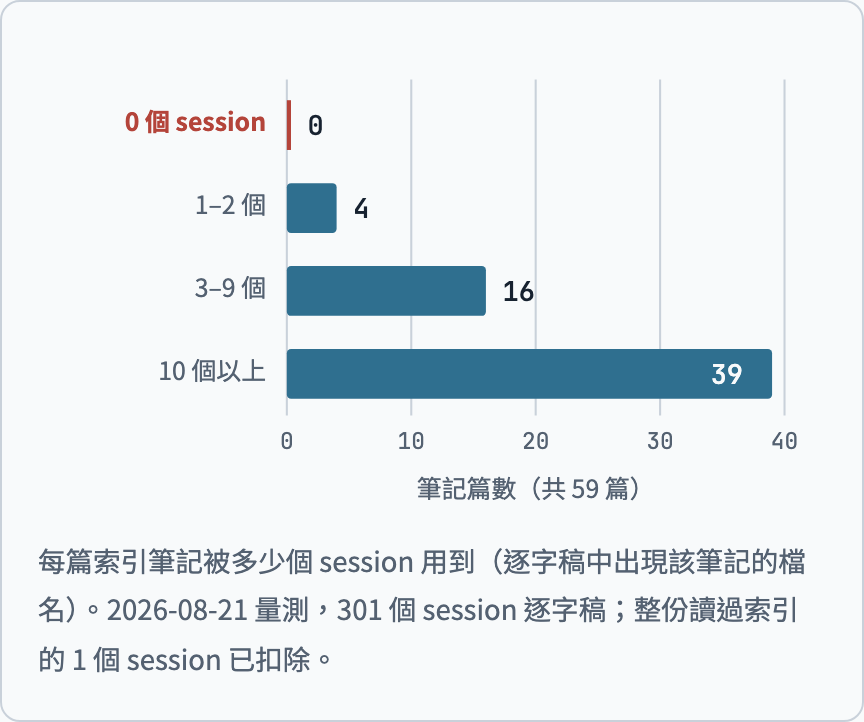
圖 6. 每篇索引筆記被多少個 session 用到。「用到」指該 session 的逐字稿中出現這篇筆記的檔名。2026-08-21 量測,301 個 session 逐字稿、59 篇索引筆記;整份讀過索引的 1 個 session 已扣除。
「來壓縮記憶索引吧,裡面一定很多過時條目」這個提議反覆出現,我們終於拿 301 個 session 的逐字稿逐條比對:沒有任何一篇是零命中。要清理的目標是空集合。
更重要的是,最關鍵的鐵律本來就很少被查,因為 AI 不知道自己正在犯錯。用使用頻率來砍鐵律,等於拆掉自己的煞車。
六個坑速查
這一年踩過的六個坑,詳細經過寫在另一篇一年心得文章。這裡只列速查表。
| AI 當下腦中的那句話 | 教訓 | 檢查動作 |
|---|---|---|
| 「工具說成功了,應該好了吧」 | 工具回報只是宣稱,不是證據 | 在使用者會看到的地方,親自讀一次最終狀態 |
| 「錯誤數是 0,所以沒問題」 | 0 也可能代表根本沒跑到那一步 | 搭配一個「確實跑完」的訊號 |
| 「那道檢查我們早就寫好了」 | 零個呼叫點就是死碼 | 數呼叫點,扣掉定義與測試後還剩幾個 |
| 「記憶裡寫著這個工具不支援」 | 否定句是有日期的快照 | 筆記加 expires;查無結果時附上試過的關鍵字 |
| 「來壓縮記憶索引吧」 | 動工前先量分母 | 零值要兩種獨立計量都同意 |
| 「交回來的結論跟我想的一模一樣」 | 未驗證的想法要寫成問句 | 拿原始資料比對,不拿自己的預期比對 |
這套做法的取捨
純文字檔加觸發詞索引好讀好改,但也有維護成本與檢索上的限制。
我們選擇純文字檔與觸發詞索引,是因為工作區由多個 AI CLI 共用,我們希望每一筆記憶都能被人讀懂、直接修改,出錯時也能追到是哪一次寫入造成的。這個選擇也有明確的代價:
- **索引要持續維護。**觸發詞寫不好就查不到;新增一則筆記,就要決定它該掛在哪一層索引、用什麼症狀當觸發詞。
- **啟動索引有大小上限。**條目一多就必須分層,否則尾段會被截掉。
- **檢索靠關鍵字。**換一種說法描述同一件事,關鍵字比對可能找不到,所以觸發詞要寫成 AI 當下真的會說的話。
- **我們沒有和向量檢索方案做過對照測試。**本文的數字只代表我們自己的工作區,不能拿來證明這套做法比其他方案好。
如果你的情境是單人或小團隊、多個 AI 工具共用同一個工作區,而且重視記憶內容可讀、可改、可追蹤,這套做法值得參考;如果需要從大量對話中做模糊的語意搜尋,向量檢索方案可能更合適。
想自己試試看
Ghost In Shell 以 MIT 授權開源。把 repo clone 下來之後,三行指令就能建立工作區並檢查知識筆記:
git clone https://github.com/cyhsieh817/Ghost_In_Shell
cd Ghost_In_Shell
pip install -e .
gish init ./my-workspace
gish knowledge lint --workspace ./my-workspace