你有一個跑在本機的 AI 客服機器人,它很聰明,回答正確率也不差,然而每次看它的回覆,總覺得哪裡怪怪的:語氣太生硬、用詞不對味、對自家產品的細節一問三不知。於是你花了好幾天調 system prompt,效果卻有限,改了 A 壞了 B,永遠在打地鼠。
這就是我在公司 LINE 客服機器人上遇到的問題,所以最後我決定直接微調(fine-tune)模型,讓它從骨子裡學會品牌語言。結果只用了 76 筆訓練資料、一張 RTX 4060 Ti、大約 3 小時,就把 accuracy 從 55% 拉到 91%。
這篇文章完整記錄了整個過程,包含我在 Windows CUDA 環境踩過的每一個坑。
為什麼 System Prompt 不夠,需要微調?
System prompt 的本質是「每次對話開頭的指令」,它能告訴模型「你是誰」,卻沒辦法真正改變模型的行為模式。具體來說,有三個限制:
語氣一致性差。你在 system prompt 裡寫「請用親切的口語回答」,模型有時照做,有時又跑回學術腔。這是因為 system prompt 只是提示,不是約束。
領域知識記不住。你把整份產品手冊塞進 system prompt,於是 token 數爆炸,推論速度變慢,模型也不見得能正確引用裡面的內容。
格式控制不穩定。你要求「回答不超過三句話」,模型第一輪乖乖聽話,然而聊了幾輪就開始寫小作文。
微調的做法不一樣,因為它直接修改模型的權重,讓模型「內化」你要的行為。所以 76 筆精心設計的範例,比 5000 字的 system prompt 更有效。
76 筆訓練資料長什麼樣
訓練資料用 ChatML 格式,每筆包含 system、user、assistant 三個角色的對話。system prompt 和線上部署的版本完全一致,這很重要,因為要確保模型學到的行為和實際部署環境一致。
76 筆資料的主題分布如下:
| 主題 | 筆數 | 說明 |
|---|---|---|
| 問候 / 身份確認 | 5 | 打招呼、自我介紹 |
| 產品介紹 | 8 | 核心產品知識 |
| 價格 / 採購 | 4 | 報價與購買流程 |
| 訂購 / 樣本申請 | 8 | 下單與試用申請 |
| 時程說明 | 5 | 出貨與排程 |
| 目標族群 | 5 | 適用對象 |
| 複測說明 | 6 | 回診追蹤 |
| 安全 / 隱私 | 5 | 資料保護 |
| 離題處理 | 4 | 引導回正題 |
| 報告解讀 | 5 | 檢測報告說明 |
| 分數解說(五級) | 11 | 各級別意義 |
| 趨勢追蹤 | 6 | 數值變化判讀 |
| 補充知識 | 4 | 延伸衛教 |
重點在於涵蓋實際客服會遇到的所有場景,而不是單一主題灌大量。76 筆不多,但每筆都是精挑細選的代表性對話。
環境建置:七個坑,一個比一個深
這段是整篇文章的核心。我在 Windows + SSH + CUDA 環境下搞 QLoRA,踩到的坑多到可以寫一本書。以下按遇到的順序整理。
坑 1:pip 自動覆蓋你的 CUDA PyTorch
你很開心地用 pip install 裝好了 CUDA 版 PyTorch 2.6.0+cu124,然後開始裝 transformers、peft、trl 這些訓練套件。裝完一看,PyTorch 被覆蓋成 CPU 版了。
為什麼?因為這些套件只宣告 torch>=2.0,pip 的 dependency resolver 發現 PyPI 上有更新的版本(而且是 CPU wheel),就自動幫你「升級」了。
解法:所有訓練套件先裝完,最後才用 --force-reinstall --no-deps 強制釘回 CUDA 版。
pip install torch==2.6.0+cu124 torchvision==0.21.0+cu124 torchaudio==2.6.0+cu124 \
    --index-url https://download.pytorch.org/whl/cu124 \
    --force-reinstall --no-deps
這不是建議,是鐵律。
坑 2:triton-windows 炸掉 peft
本來想用 unsloth 加速訓練,結果 unsloth 拉入的 triton-windows 3.7.1.post27 把 AttrsDescriptor 從 triton.compiler.compiler 裡移除了,但 peft 0.19.1 還在用舊 API,於是 import peft 直接報錯。
解法:放棄 unsloth,回歸標準 transformers + peft + trl 組合。訓練速度慢了約 20-30%,但 76 筆資料的規模根本感覺不出來。
教訓很簡單:對小規模微調來說,穩定性遠比速度重要。
坑 3:bitsandbytes 版本三選一
bitsandbytes 是 QLoRA 4-bit 量化的核心套件。Windows 上的版本選擇是一門學問。
| 版本 | 狀況 |
|---|---|
| 0.49.2 | 要求 torch >= 2.11,和 2.6.0 不相容 |
| 0.45.5 | 安裝時又拉入 CPU 版 torch |
| 0.46.1 | Windows CUDA 支援,torch 2.6.0 相容 |
最後用 0.46.1 搭配 --no-deps 安裝才解決。
坑 4:Windows DLL 載入衝突,Exit Code 5
這是最玄的一個坑。執行 from trl import SFTTrainer 的時候,Python 直接死掉,exit code 5,沒有任何錯誤訊息。不是 exception,是整個程序被作業系統強制終止。
根因是 Windows 上的 DLL 載入順序衝突。import torch 會先載入 CUDA DLL,之後 SFTTrainer 觸發 pyarrow 的 C extension 載入,於是兩邊的 DLL 版本打架。
解法:在 import trl 之前,先 preload pandas 和 pyarrow。
import pandas                    # noqa: F401
import pyarrow.pandas_compat     # noqa: F401
# 然後才能安全地 import trl
from trl import SFTTrainer
import 順序的鐵律是:pandas → pyarrow → trl → torch → transformers/peft。
坑 5:ruff 自動刪掉你的救命 import
上面那個 import pandas 是 preload 用的,程式碼裡不會直接用到。問題來了:我的編輯器設了 ruff formatter hook,它看到「unused import」就自動刪除,於是刪掉之後 exit code 5 又復發。
解法:在 import 行尾加 # noqa: F401,告訴 ruff 這行是故意的,不要動。同時用 Python 的 open() 直接寫檔,繞過編輯器的自動格式化。
坑 6:SSH session 吃不到 Google Drive
訓練資料放在 Google Drive(G: 磁碟機),在桌面環境一切正常,但透過 SSH 連進去就看不到 G: 。
原因是 Google Drive 是 user-space filesystem,只在 Windows session 1(桌面)掛載。SSH 跑在 session 0,所以根本看不到這顆磁碟。
解法:從另一台有 Google Drive 同步的機器,用 SCP 直接把檔案傳過去。路徑只用 ASCII,避免中文路徑在 SSH 下又出問題。
坑 7:trl 0.24.0 的 API 破壞性變更
最後一個坑是 trl 0.24.0 改了一堆 API 名稱,照舊文件寫會直接報錯。
| 舊 API | 新 API |
|---|---|
SFTConfig(max_seq_length=...) |
SFTConfig(max_length=...) |
SFTTrainer(tokenizer=...) |
SFTTrainer(processing_class=...) |
warmup_ratio=... |
warmup_steps=... |
這種破壞性變更在快速發展的 ML 生態系很常見。靠官方文件不如靠錯誤訊息,每次升版都要重新驗證 API。
訓練參數與結果
環境搞定之後,訓練本身反而是最簡單的部分。
關鍵參數
基底模型:Qwen/Qwen3.5-9B
LoRA rank:16 / alpha:32
Epochs:3
Batch size:2(gradient accumulation 4,effective batch = 8)
Learning rate:2e-4
Max sequence length:1024
Target modules:q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj
VRAM 分配(RTX 4060 Ti 16GB)
| 項目 | 佔用 |
|---|---|
| 4-bit 模型權重(9B) | ~5 GB |
| LoRA adapter + 梯度 | ~4 GB |
| 活化值、optimizer | ~4 GB |
| 預留 | ~3 GB |
| 合計 | ~16 GB(剛好塞滿) |
訓練結果
實際耗時 3 小時 18 分鐘。Loss 和 accuracy 的變化如下:
| 階段 | Loss | Accuracy |
|---|---|---|
| Step 10(Epoch 1 末) | 2.141 | 55.0% |
| Step 20(Epoch 2 末) | 0.703 | 83.96% |
| Step 30(Epoch 3 末) | 0.386 | 90.94% |
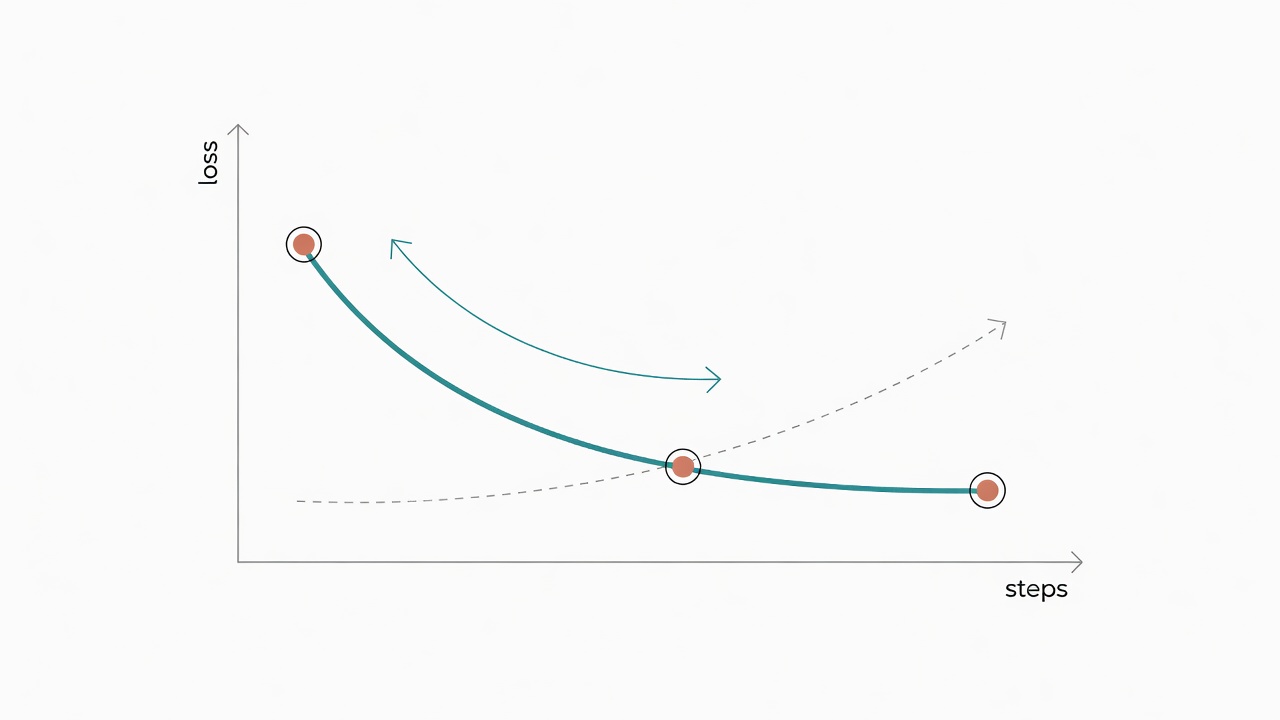
grad_norm 穩定在 0.14-0.28,沒有梯度爆炸。可訓練參數只有 29,097,984 個,佔整個 9B 模型的 0.32%。LoRA adapter 最終大小 111 MB。
後訓練三部曲:Merge、GGUF、Ollama
訓練完拿到的是 LoRA adapter,不能直接拿來推論,所以需要三個步驟才能上線。
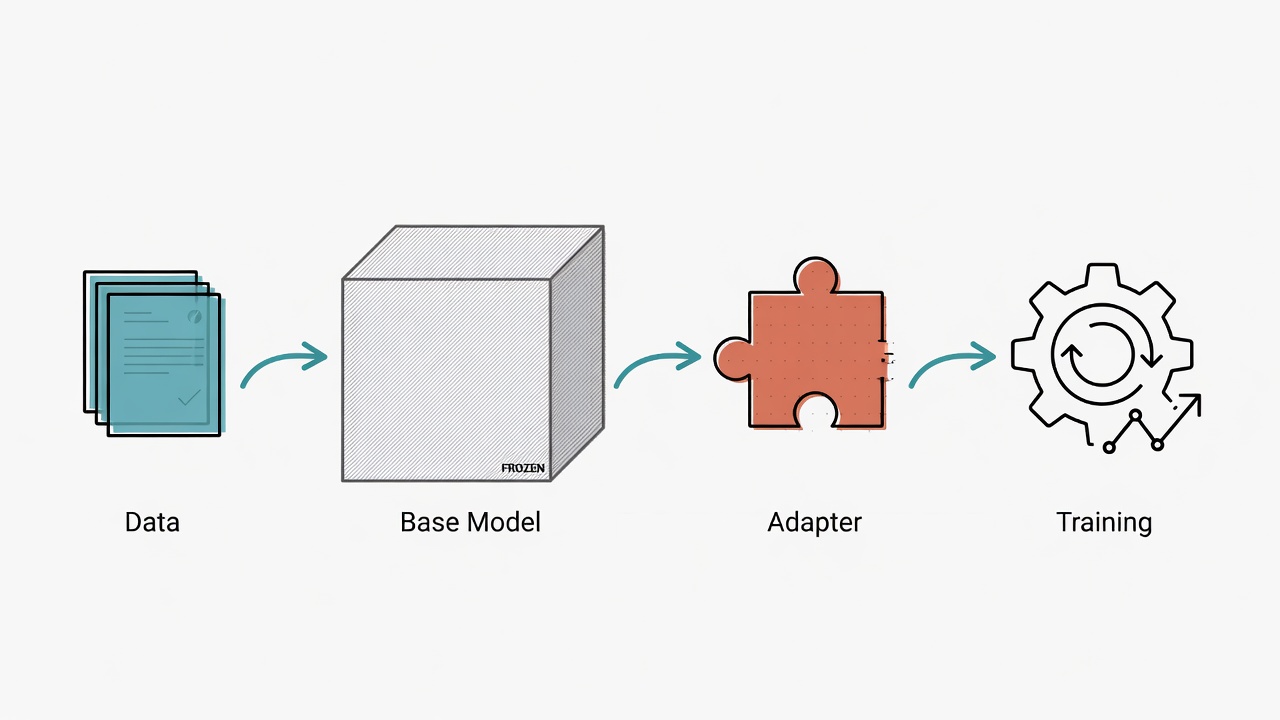
Step 1:合併 LoRA 到基底模型
用 peft 的 merge_and_unload() 把 LoRA 權重合回基底模型。這步要在 CPU 上做,不然 16GB VRAM 不夠。大約 30 秒就能完成,產出 5 個 safetensors shard,共約 18 GB(FP16)。
Step 2:轉換成 GGUF 格式
Ollama 只吃 GGUF,所以需要用 llama.cpp 的轉換工具。這裡又踩了一個坑:PyPI 上的 gguf 套件版本落後 llama.cpp master,缺少 MODEL_ARCH.DFLASH 定義。解法是直接從 llama.cpp repo clone 最新的 gguf-py 來裝。
量化格式我選 Q8_0,理由很簡單:
- F16(18 GB)超出 16GB VRAM,不能用
- Q8_0(~9.5 GB)剛好,還有 ~6 GB 留給 KV cache
- Q4_K_M 需要另外編譯 Windows 版
llama-quantize,增加複雜度
另外要注意 MTP(Multi-Token Prediction)tensor 的問題。Qwen3.5 的 config 裡有 mtp_num_hidden_layers: 1,但 Ollama 0.30.11 的 llama.cpp 還不支援這個格式,於是第一次轉換出來的 GGUF 載入就報 missing tensor 'blk.32.attn_norm.weight'。加上 --no-mtp 旗標重轉就解決了。
Step 3:Ollama 部署
寫一個 Modelfile,指定 GGUF 路徑和推論參數:
FROM cellergy35-q8-nomtp.gguf
PARAMETER num_ctx 32768
PARAMETER presence_penalty 1.5
PARAMETER temperature 0.7
然後 ollama create cellergy35:v2 -f Modelfile,9.5 GB 的模型載入成功。
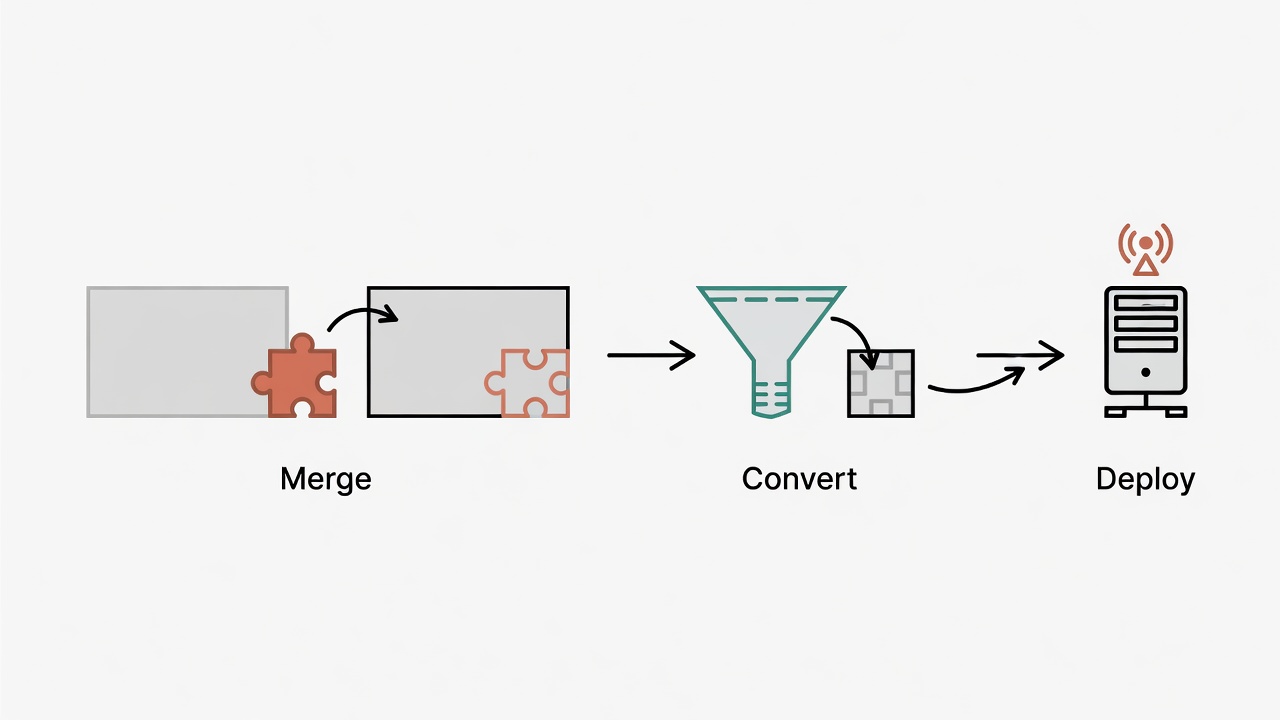
驗證與上線
部署完成後,我測了幾個關鍵問題。模型能正確回答產品知識、報告解讀,語氣也和訓練資料裡的範例一致。唯一要注意的是 Qwen3.5 預設會用英文回答,所以部署時需要在 Hermes 的 profile 裡注入繁體中文的 system prompt。
最後把 Hermes LINE Bot 的 model 欄位從 qwen3.5:9b 換成 cellergy35:v2,重啟 profile,上線完成。
Windows CUDA 環境微調五大鐵律
走過這一整趟,我整理出五條鐵律。每一條都是用 debug 時間換來的。
第一條:CUDA PyTorch 永遠最後裝,搭配 --no-deps。 pip 的 dependency resolver 會覆蓋你的 CUDA 版本,這不是 bug,是 pip 的設計。唯一的防線是最後才裝、強制指定版本。
第二條:Windows 上的 import 順序是生死問題。 pandas → pyarrow → trl → torch → transformers/peft,順序錯了就是 exit code 5,沒有錯誤訊息,只有沉默的死亡。
第三條:preload import 一定要加 # noqa: F401。 不然 linter 和 formatter 會幫你把救命的 import 刪掉。
第四條:SSH session 和桌面 session 是兩個世界。 Google Drive、中文路徑、某些環境變數,在 SSH 下通通失效。檔案傳輸用 SCP,路徑只用 ASCII。
第五條:小規模微調選穩定性,不選速度。 unsloth 很快,但在 Windows 上和 peft 打架。76 筆資料用標準 stack 跑 3 小時就搞定,不值得為了省 1 小時去冒穩定性的風險。
這五條適用於任何在 Windows + CUDA 環境下做 QLoRA 微調的人。祝你少踩一些坑。