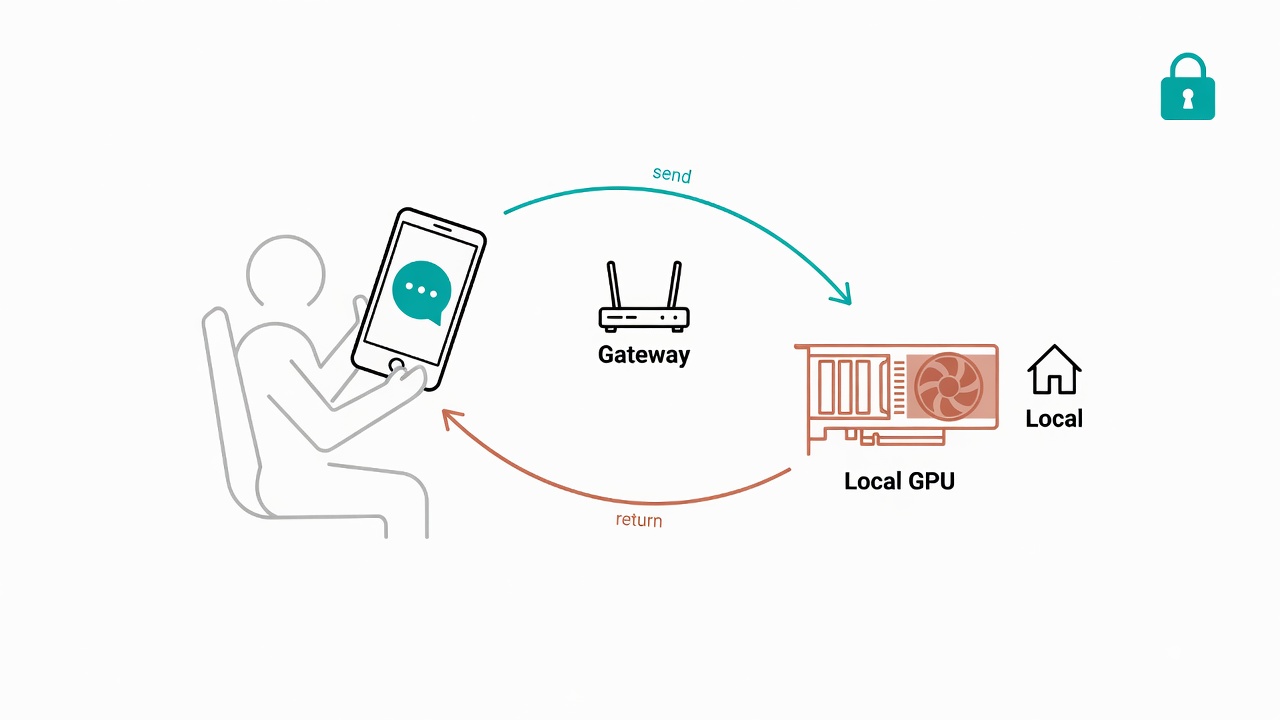
你想讓公司的 LINE 官方帳號有 AI 客服,但 OpenAI API 一個月燒掉好幾千塊?或者你在意客戶對話資料全部送到第三方伺服器?這篇文章記錄我如何用一張 RTX 4060 Ti、一台公司的 Windows 主機,從零搭起一個完全在本地運行的 LINE 客服機器人。因為每個環節都自己走過一遍,我把過程中踩的六個坑全寫下來,每一個都是用時間實打實換來的教訓。
為什麼要用本地 LLM 做 LINE 客服?
先講結論:成本、隱私、自主性,三個理由同時成立的時候,本地部署就是最佳解。
成本面,雲端 API 按 token 計費,客服場景一天幾百則對話跑下來,帳單很有感。本地跑模型正好相反,硬體是一次性投資,所以之後邊際成本趨近於零。
隱私面,客服對話涉及客戶個資、產品諮詢內容,甚至健康相關資訊。因為本地部署讓資料完全不出公司內網,合規壓力小很多。
自主性,模型可以換、可以微調、system prompt 想怎麼改就怎麼改,不用看任何平台的臉色。而且資料和模型都在自己手上,所以未來要針對特定產品做 fine-tune,隨時能動手。
想清楚這三點之後,接下來就是怎麼把架構搭起來。
硬體與架構總覽
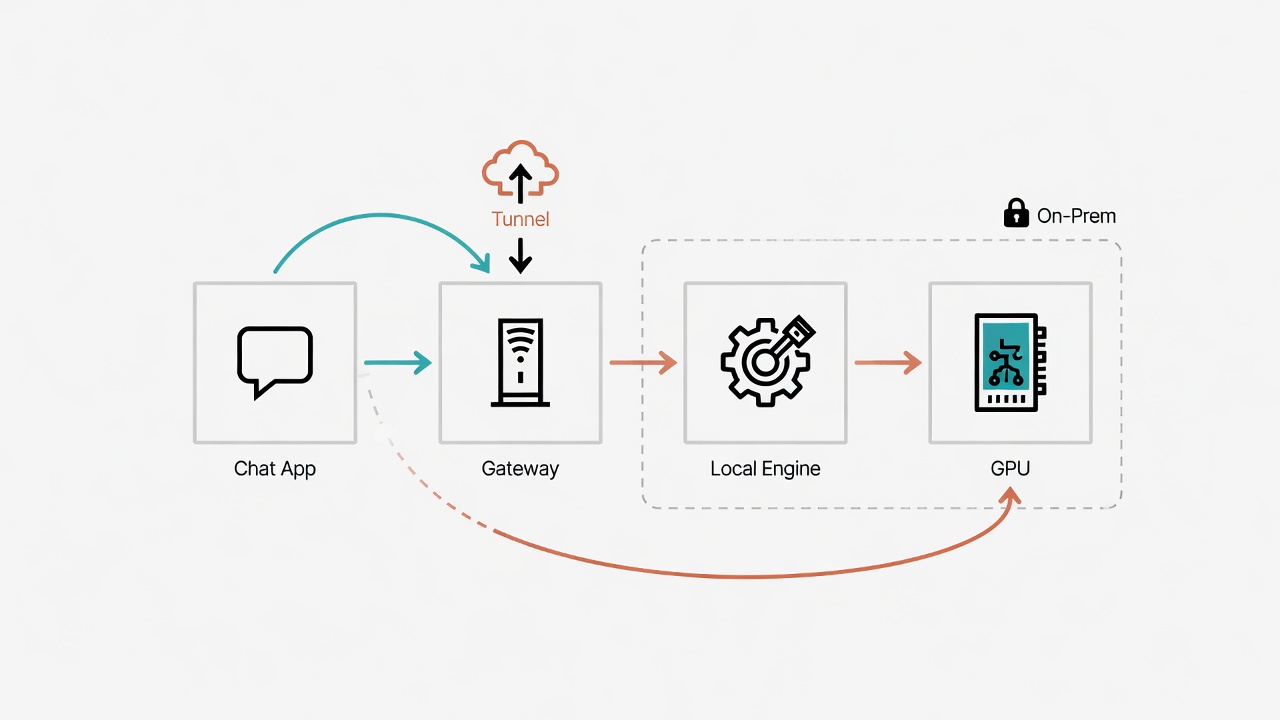
整個系統的架構其實不複雜,四個元件串起來就好:
- LINE Messaging API:接收使用者訊息、回傳回覆。
- Hermes Gateway:中間層閘道,負責把 LINE Webhook 收到的訊息轉成 LLM 能吃的格式,再把回覆送回 LINE。它跑在 port 8646,透過 Cloudflare Tunnel 對外。
- Ollama:本地 LLM 推理引擎,跑在
127.0.0.1:11434。 - RTX 4060 Ti 16GB:實際扛推理運算的 GPU。
機器是公司內網的一台 Windows 主機,32 GB RAM,透過 Cloudflare Access SSH 從外部管理。由於 Hermes 設定成 Windows Task Scheduler 開機自啟,不需要有人坐在那台電腦前面。
這套架構的好處是每一層都可以獨立替換。因為元件之間只靠標準介面溝通,想換模型就改 Ollama 的 model name,想換通訊平台就靠 Hermes 支援的多種 adapter,想換 GPU 則交給 Ollama 自動偵測。
模型選型:為什麼是 Qwen3.5 9B?
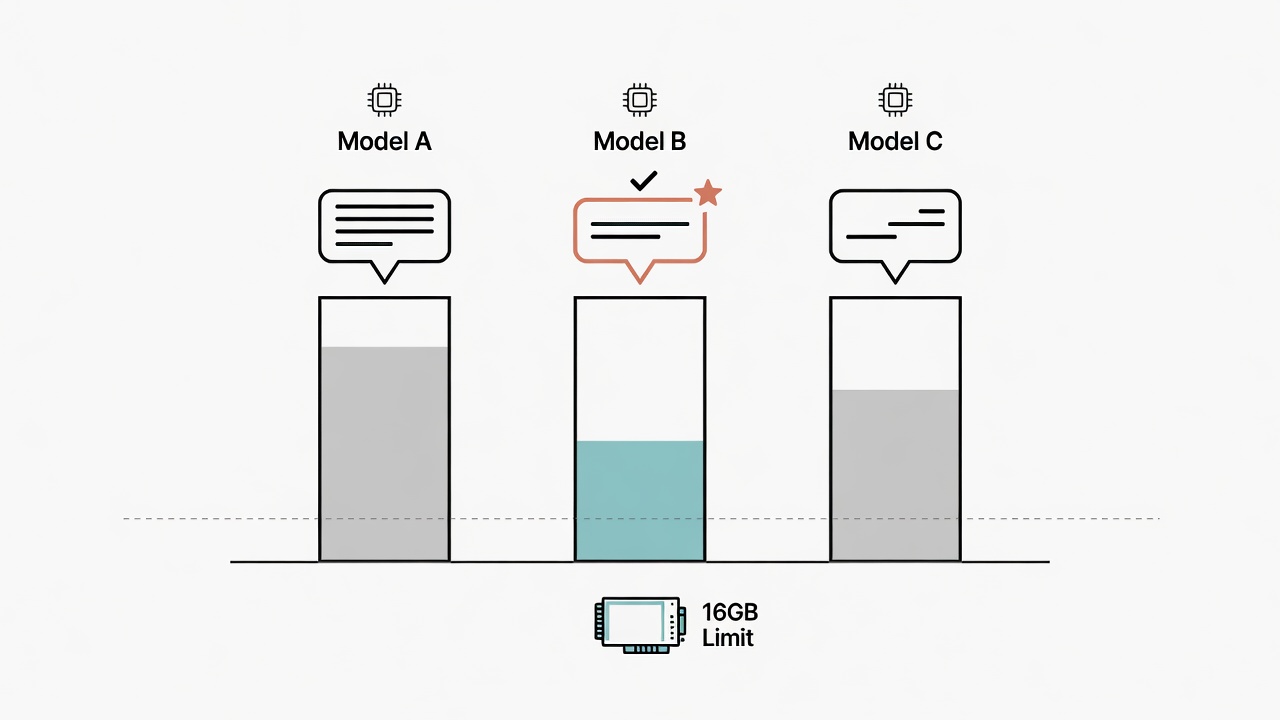
選模型是整個專案最關鍵的決策,我的篩選條件很明確:
- VRAM 要塞得下:RTX 4060 Ti 有 16 GB,扣掉系統佔用,模型最好控制在 8 GB 以內。
- 繁體中文要夠強:這是台灣市場的客服,回覆品質直接影響品牌形象。
- 能微調:短期先用 system prompt 撐,中長期要做 SFT,授權必須開放。
最終選定 Qwen3.5 9B。Q4_K_M 量化後只吃 6.6 GB VRAM,推理毫無壓力。多語言覆蓋很廣,完整清單在官方 model card 上;就我自己實際跑下來,Qwen 系列在繁體中文的底子是開源模型裡最好的一批。Apache 2.0 授權,Unsloth SFT 完整支援,未來微調不受限。我看過的幾份同尺寸開源模型公開排行,它都落在前段班,綜合表現很穩。
拉取指令只需要一行:
ollama pull qwen3.5:9b
不過選對模型只是開始,真正的挑戰在後面的六個坑。
六個踩坑實錄
坑一:Gemma4 的 template 靜默丟掉 system prompt
一開始我其實先試了 Gemma4。模型跑起來,LINE bot 也有回覆,但回覆的語氣跟內容完全不對。明明設了「你是 Cellergy 官方客服小助手」的 system prompt,回覆卻像一個什麼都不知道的通用助理。
查了半天才發現,Ollama 預設的 Gemma4 Modelfile 裡,template 只有 {{ .Prompt }},根本沒有 {{ .System }} 這個變數。也就是說,你設了 system prompt,模型完全不會看到。因為它不會報錯,只是靜靜地把你的設定丟掉,這一點最可怕。
解法是建立自訂模型,在 Modelfile 裡把 {{ .System }} 加回去。但後來我改用 Qwen3.5,這個問題就自然消失了。不過教訓是:任何模型上線前,第一件事先確認 Modelfile 的 template 有沒有包含 {{ .System }}。
坑二:中文 system prompt 被 ASCII filter 清空
換到 Qwen3.5 之後,我很自然地用中文寫了 system prompt。結果 LINE bot 還是沒有任何人設,像裸奔一樣。
這次的根因更隱蔽。Hermes 在 Windows 環境下,遇到 cp950 編碼錯誤時會觸發內部的編碼保護機制(類似 _strip_non_ascii()),把 system prompt 裡所有非 ASCII 字元清掉。因為中文全部是非 ASCII 字元,你精心撰寫的整段 persona 設定,在送進模型之前就變成空字串了。
解法意外地簡單:system prompt 全部改用英文撰寫。 語言規則用英文描述("Reply ONLY in Taiwan Traditional Chinese"),模型照樣能正確回覆繁體中文。由於根因出在 Windows 的 cp950 編碼,Linux 或 macOS 不會遇到這個問題。
坑三:Qwen3.5 的 thinking mode 讓回應慢到不能用
解決了 persona 問題,回覆內容終於正確了。但新的問題來了:每則回覆要等 3 到 4 分鐘。客服機器人等 3 分鐘才回話,使用者早就離開了。
原因是 Qwen3.5 預設啟用了深度推理的 thinking mode,每次回覆前會先跑一大段 chain-of-thought。我試著在 Modelfile 加 PARAMETER think false,Ollama 直接報 unknown parameter,不吃這個設定。
最後找到的解法是在 template 裡預先注入一個空的 think block:
<|im_start|>assistant
<think>

</think>
因為模型看到 think block 已經「完成」了,就會跳過思考直接輸出回覆。效果非常顯著:回應時間從 3 到 4 分鐘直接降到 9 到 11 秒,而且輸出裡不會出現任何 <think> token。
坑四:「Still thinking」卡片關不掉
回應速度壓到 10 秒左右之後,Hermes 那邊還有一個煩人的問題。它在偵測到模型回應超過閾值時會自動發一張「Still thinking...」的卡片給使用者。雖然現在已經很快了,但這張卡片偶爾還是會跳出來。
我在 config.yaml 的 platforms.line 底下設了 slow_response_threshold: 0,想把閾值歸零來關掉它,結果沒有效果。
翻 Hermes 原始碼才發現,平台設定物件的固定欄位只有 enabled、token 這些,其他參數必須放在 extra 這個嵌套 dict 裡面,LINE adapter 才讀得到。正確的寫法是:
platforms:
  line:
    extra:
      slow_response_threshold: 0
差一層嵌套,效果就天差地別。
坑五:回覆混雜簡體字
功能面都搞定之後,開始做品質檢查,結果發現回覆裡偶爾會冒出「请问」「什么」這類簡體字。這對一個面向台灣消費者的品牌客服來說是不可接受的。
因為 Qwen3.5 的訓練語料包含大量簡體中文,如果 system prompt 沒有特別強調,模型就會混用。解法是在 system prompt 裡用非常強硬的語氣寫語言規則:
LANGUAGE RULES (MANDATORY):
- Reply ONLY in Taiwan Traditional Chinese (zh-TW). This is non-negotiable.
- Use ONLY Traditional Chinese characters, not Simplified Chinese.
- Simplified Chinese is strictly forbidden.
加了之後,目視檢查所有回覆都是正確的台灣繁體中文。
坑六:品牌名「Cellergy」被自行翻譯
最後一個坑比較好笑但也很致命。模型把「Cellergy」翻譯成「細胞電流助手」,把商標當成一般英文詞彙來意譯了。
解法同樣是在 system prompt 裡明確禁止:
Cellergy is a registered trademark - NEVER translate or paraphrase it into Chinese.
Always write the brand name as Cellergy in English.
icNAD+ is a product name - always keep it as icNAD+, never translate it.
因為 LLM 預設會「好心地」幫你翻譯所有外文,你必須明確告訴它哪些詞不能動。
最終配置與效果
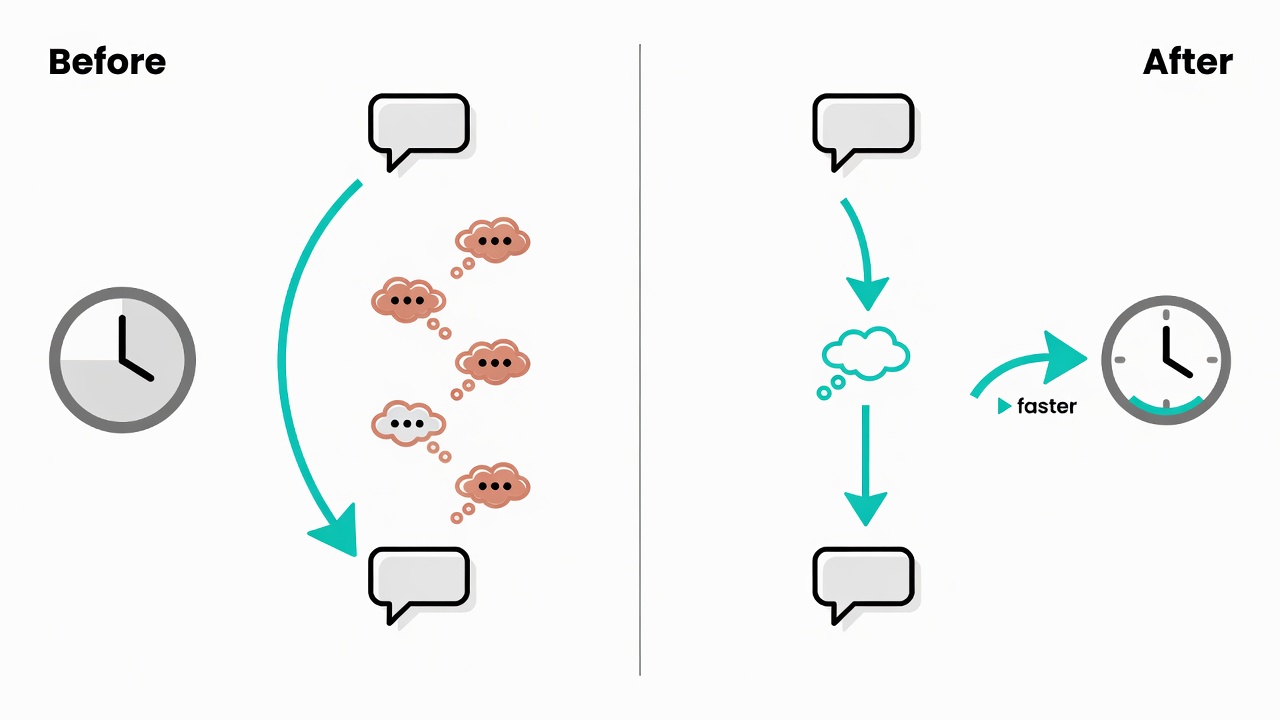
經過六輪除錯,最終上線的配置可以收斂成幾條:Ollama 跑 Qwen3.5 9B,template 帶空 think block prefill;Hermes 指向本地 Ollama,system prompt 全英文撰寫(模型回覆仍為繁中),LINE 的 slow response threshold 透過 extra 設為 0。設定檔改完後同步到 Windows 主機並重啟 Hermes 即可。
上線後的效能數據:
| 指標 | 數值 |
|---|---|
| 回應時間(Ollama API 直連) | 9-11 秒 |
| 回應時間(LINE 端對端) | 約 15-20 秒 |
| 繁體中文準確率 | 目視確認 100% |
| 品牌名保留 | Cellergy / icNAD+ 均未被翻譯 |
| thinking token 外洩 | 無 |
五條鐵律
回顧整個部署過程,我整理出五條鐵律,未來做類似專案可以直接照著檢查:
- Ollama template 是第一道防線。 系統提示失效的時候,先查 Modelfile 有沒有
{{ .System }}。 - Windows 環境的 system prompt 用英文寫。 因為 cp950 編碼的坑比你想的多,用英文寫 prompt 讓模型回繁中,是最穩的做法。
- Qwen3.5 關 thinking 不能用 PARAMETER。 只能在 template 裡 prefill 空 think block,或等 Ollama 官方支援
think: false。 - Hermes 的平台設定要放在 extra dict 裡。 因為頂層欄位只有固定的那幾個,其他全部要嵌套。
- 品牌名必須在 system prompt 裡明確列舉並禁止翻譯。 LLM 會好心幫你意譯商標,你不說它就會動。
下一步
目前的客服機器人靠 system prompt 撐住基本的回覆品質,但長期來看,通用模型對特定產品的了解深度有限。下一篇(T15)會記錄如何用 QLoRA 在同一張 RTX 4060 Ti 上對 Qwen3.5 做 supervised fine-tuning,讓模型真正學會 icNAD+ 產品的專業知識。敬請期待。