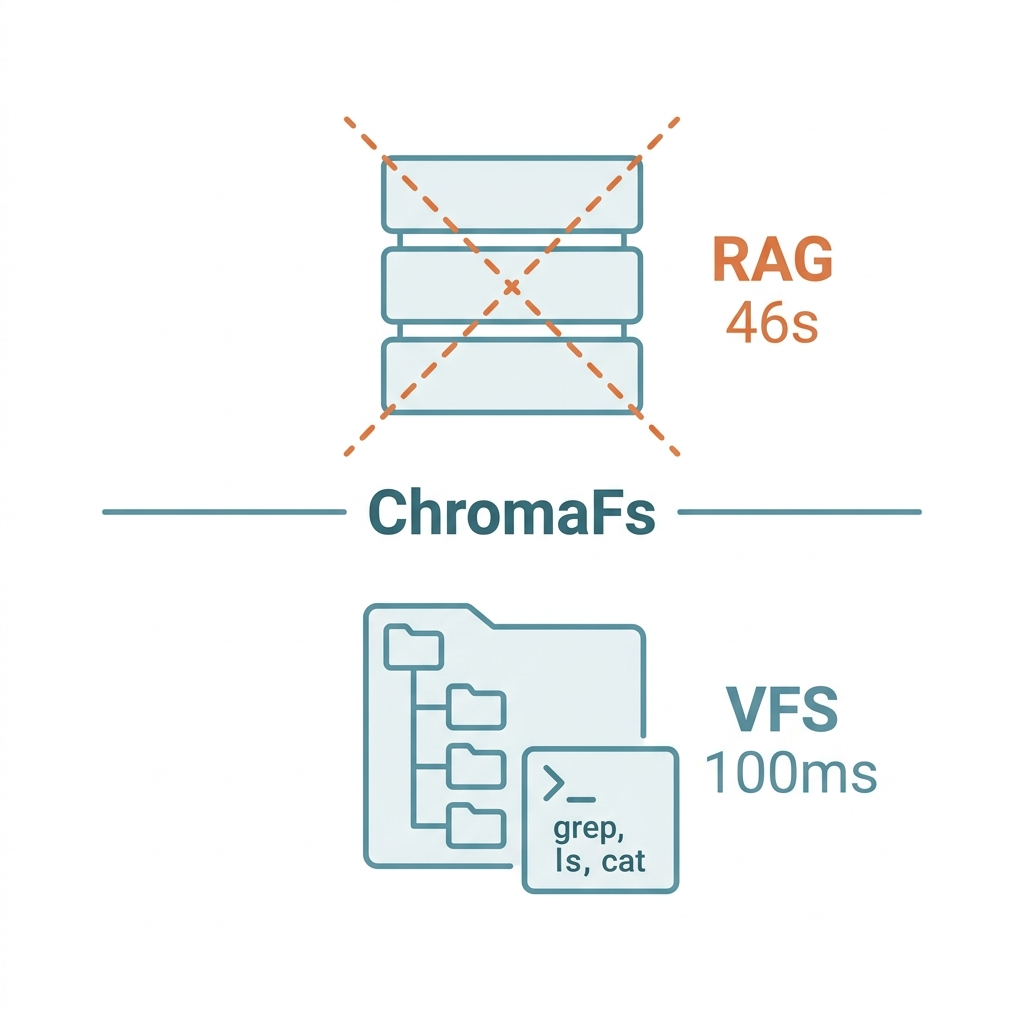
導讀:過去兩年 RAG 幾乎成了 AI 應用標配。但 Mintlify 發現,讓 AI 像人一樣用 grep、cat 瀏覽資料,更快、更準,還便宜好幾個數量級。
RAG 的隱藏成本
RAG 邏輯直覺:把文件切段存向量庫,有問題搜相關段餵給 AI 組答案。實際使用有三痛點:
答案若分散在五個不同頁面段落,RAG 很難湊齊;精確搜尋(「/v2/users 的錯誤碼列表」)需要完全吻合的語法,向量搜尋擅長語義相似度而非精確匹配;每次查詢都要啟動沙盒——Mintlify 的沙盒啟動要 46 秒,用戶等不了。
假裝有個檔案系統
ChromaFs 核心想法出奇簡單:別真給 AI 一個沙盒,造一個「假的」檔案系統。AI 下達 grep "error code" /docs/api/,ChromaFs 把它翻譯成向量資料庫查詢。
AI 以為在瀏覽檔案系統,實際在查資料庫。介面是它熟悉的 ls、cat、grep、find,能自然組合層層深入。
效果:Session 建立從 46 秒降到 100 毫秒——快 460 倍。邊際計算成本降到零,直接重用既有向量庫基礎設施。
RAG 不等於向量搜尋
@dotey 在 HN 討論串點出一個被忽略的事實:RAG 和向量搜尋被不必要綁在一起。RAG 的「R」是 Retrieval,但檢索不必用向量搜尋——全文搜尋、SQL、grep,都是檢索手段。
現代 AI 有工具使用與推理能力,能自己判斷該用哪種策略:API 規格用 grep,未知主題用語義搜尋,結構化數據用 SQL。把策略寫死反而限制 AI 能力。
ChromaFs 不是取代 RAG,而是讓 AI 選擇最適合當前任務的檢索方式。
為什麼這件事很重要
對建構 AI 應用的團隊:別因為「大家都用 RAG」就預設它最佳。先問——用戶查資料模式是什麼?結構化瀏覽(明確目錄層級),檔案系統介面更優;開放式探索(不知答案在哪),向量搜尋才是強項。
對一般使用者:給 AI 「瀏覽」的機會,而不只「提問」。與其問「X 的錯誤碼是什麼?」,不如讓它先看整個文件結構再找答案。就像到新圖書館先看書架分類,比直接問館員更有效率。
最好的檢索策略,是讓 AI 自己選擇檢索策略。
References
- Building a Virtual Filesystem for Mintlify's AI Assistant. 2026.
- @dotey. Thread: ChromaFs Architecture Analysis. 2026.
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020.