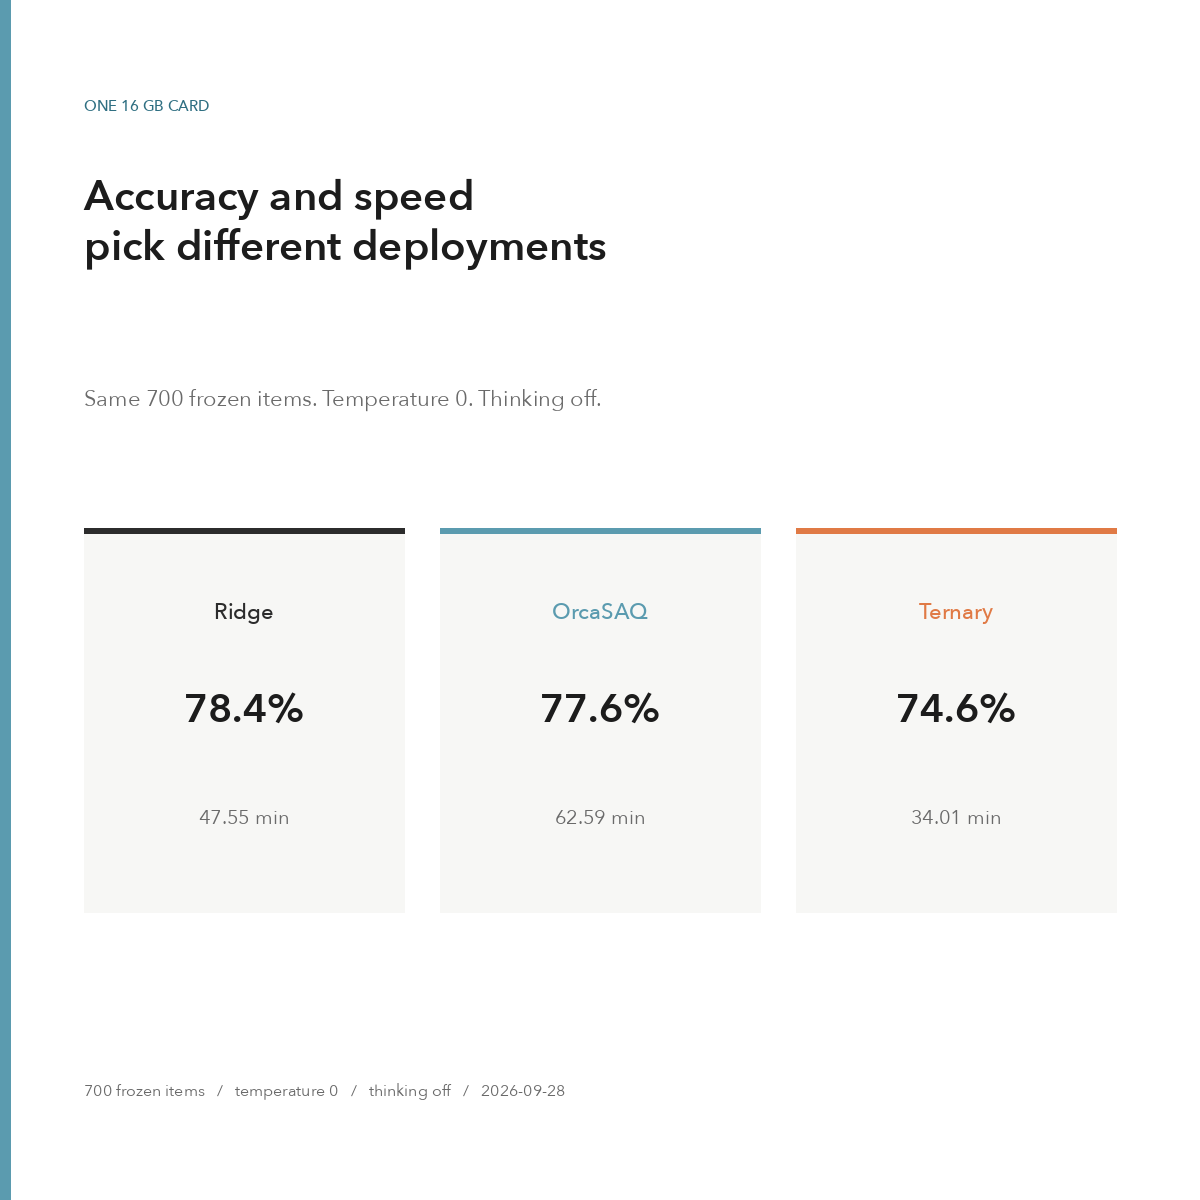
就像三台車擠在同一條車道:準確率 78.4% 的那套,不是最先跑完的那套。我們該怎麼在 16GB 上挑一套日常部署?
2026-09-28,同一台 Windows 工作站、同一張 NVIDIA RTX 4060 Ti 16GB,三套都能放進顯示記憶體的部署,輪流跑同一份凍結的 700 題。Ridge 答對 549 項,OrcaSAQ 答對 543 項,Ternary 答對 522 項。牆鐘反過來。Ternary 用 34.01 分鐘,Ridge 用 47.55 分鐘,OrcaSAQ 用 62.59 分鐘。準確率的排序和抵達時間的排序,不是同一條。
先把契約講清楚
手上只有一張 16GB 卡時,準確率冠軍和速度冠軍往往不是同一套部署。
這篇回答的是一個很窄的契約。七套公開基準各凍結 100 題,三臂看到的是同一份清單。裁判只抽選擇題字母,或數值題的最終答案。它不問句子好不好看,也不問工具有沒有接上。另一篇 2026-09-19 的筆記,問的是短題、長文針刺與工具迴圈都過了之後,日常別名能不能指到 Ternary。那是另一個問題。這篇不改寫那個結論,也不把這 700 題說成日常工作的全部。
三套 runtime 輪流用掉同一張卡,不能同時管著三個服務。16GB 裝得下其中一套的權重,不代表三套可以並排常駐。我們把三臂的題目雜湊對過,三邊相同。所以差出來的是部署,不是題目抽籤。
這次比的是三套部署
三套都能進 16GB,但量化格式、執行環境與打包方式都不一樣。
三套的共同上游是 Qwen3.8-27B。模型卡寫的授權是 Apache 2.0,上下文長度 262,144。[1] 這次沒有跑官方未量化檢查點。比的是三個已經能在 16GB 卡上服務的實例。
Ridge 這臂的服務名稱是 Qwen3.8_Ridge,走 Ollama。公開的 Empero Ridge 3.7 bpw 是這個名稱在登記上的對應檔:混合 GGUF,檔案約 11.73 GiB(12.59 GB),模型卡把 16GB 寫成務實的起點,那是他們的硬體建議,不是我們這張卡的 VRAM 實測。[2] 本輪沒有重算權重雜湊,所以不能宣稱位元組等同於那個檔。
OrcaSAQ 這臂是 OrcaSAQ-2-27B,EXL3,走 vLLM。模型卡寫約 12.3 GB、3.21 bpw,thinking 預設開著,建議溫度 1.0。卡片上的 SWE-bench Pro 70.0 是他們用 vLLM 報的代理測驗,不是這 700 題。[3]
Ternary 這臂的檔名是 Ternary-Bonsai-2-27B-PQ2_0-MTP-Q8_0.gguf,執行環境是 Prism 的 llama.cpp MTP。這個檔名與 ProCreations 的 MTP 檔 相同。對方寫明這是實驗性 MTP 頭,不是 Prism 官方釋出,檔案約 7.658 GB,而且 stock llama.cpp 不夠。[5] Prism 自己的 PQ2_0 是 7.21 GB、2.13 bit/weight 的三值打包,模型卡寫 stock llama.cpp 會拒載或產生垃圾,thinking 模式的建議溫度是 1.0,14 項 thinking 基準的平均是 84.78。[4] 那 84.78 是另一套題、另一套取樣。我們不把 74.6% 和 84.78 相減。本輪同樣沒有核對權重雜湊。
如同大衣塞進登機箱,口袋裡的鑰匙還得另外量。檔案變小,不自動等於這 700 題的答對率保持不變。三套的「小」也不是同一種小。Ridge 是對混合架構敏感張量做的混合量化,OrcaSAQ 是 EXL3,Ternary 是三值主權重再外加一顆 MTP 頭。這不是同一份權重的三種標籤。
方法只鎖客觀答案
溫度設 0、關閉 thinking、每題最多 512 token,裁判只抽最終答案。
協定是溫度 0、max_tokens 512、關閉 thinking、裁判名 objective-v1。每題單獨送,牆鐘是該次 HTTP 往返,含 prompt 處理與生成,700 題串行加總。不是 llama-bench 的 tg128,也不是並發吞吐。本次紀錄沒有寫下 context 配置。三臂各 700 列結果都在,摘要裡的請求錯誤數是 0。本文重算的是結果檔裡的 passed 標記,沒有逐題重寫裁判。
這個協定和廠商建議不一致,而且必須寫在成績前面。Prism 的成績是 thinking 模式、溫度 1.0。[4] OrcaSAQ 的卡片也把 thinking 當預設,溫度 1.0。[3] 我們關 thinking、用溫度 0,是為了讓三臂的抽答比較可對,不是為了復現他們的標題數字。你若把這份 74.6% 拿去和 84.78 比高低,比的是兩種測驗,不是兩套部署。
512 token 的上限會吃掉長答案。Ridge 有 32 題碰到上限,OrcaSAQ 有 26 題,Ternary 有 92 題。碰到上限的題,多數沒被判對。這個上限和準確率落差纏在一起,下面分項會拆開看。空預測很少:Ridge 4 題、OrcaSAQ 6 題、Ternary 8 題,全部未過。那是抽答失敗,不是傳輸錯誤。
七套的名字對得上公開基準:MMLU、MMLU-Pro、CMMLU、GSM8K、ARC-Challenge、HellaSwag、MathQA。[6][7][8][9][10][11][12] 我們用的是每套凍結的 100 題,不是完整官方測驗集。所以表上的百分比不能寫進那些論文的排行榜。
準確率差在 27 題
總分是 Ridge 549、OrcaSAQ 543、Ternary 522,三臂都沒有請求錯誤。
| 套題 | Ridge | OrcaSAQ | Ternary |
|---|---|---|---|
| MMLU | 80 | 83 | 77 |
| MMLU-Pro | 63 | 68 | 48 |
| CMMLU | 78 | 77 | 72 |
| GSM8K | 85 | 87 | 85 |
| ARC-Challenge | 96 | 94 | 92 |
| HellaSwag | 92 | 91 | 86 |
| MathQA | 55 | 43 | 62 |
| 合計 | 549 | 543 | 522 |
換算成百分比,是 78.4%、77.6%、74.6%。對 Ridge 而言,OrcaSAQ 少 6 題,約 0.86 個百分點。Ternary 少 27 項,約 3.86 個百分點。6 題的總分差,在每套只有 100 題時很薄。27 題比較厚,可是它不是七套平均各掉一點,而是集中在少數套題。
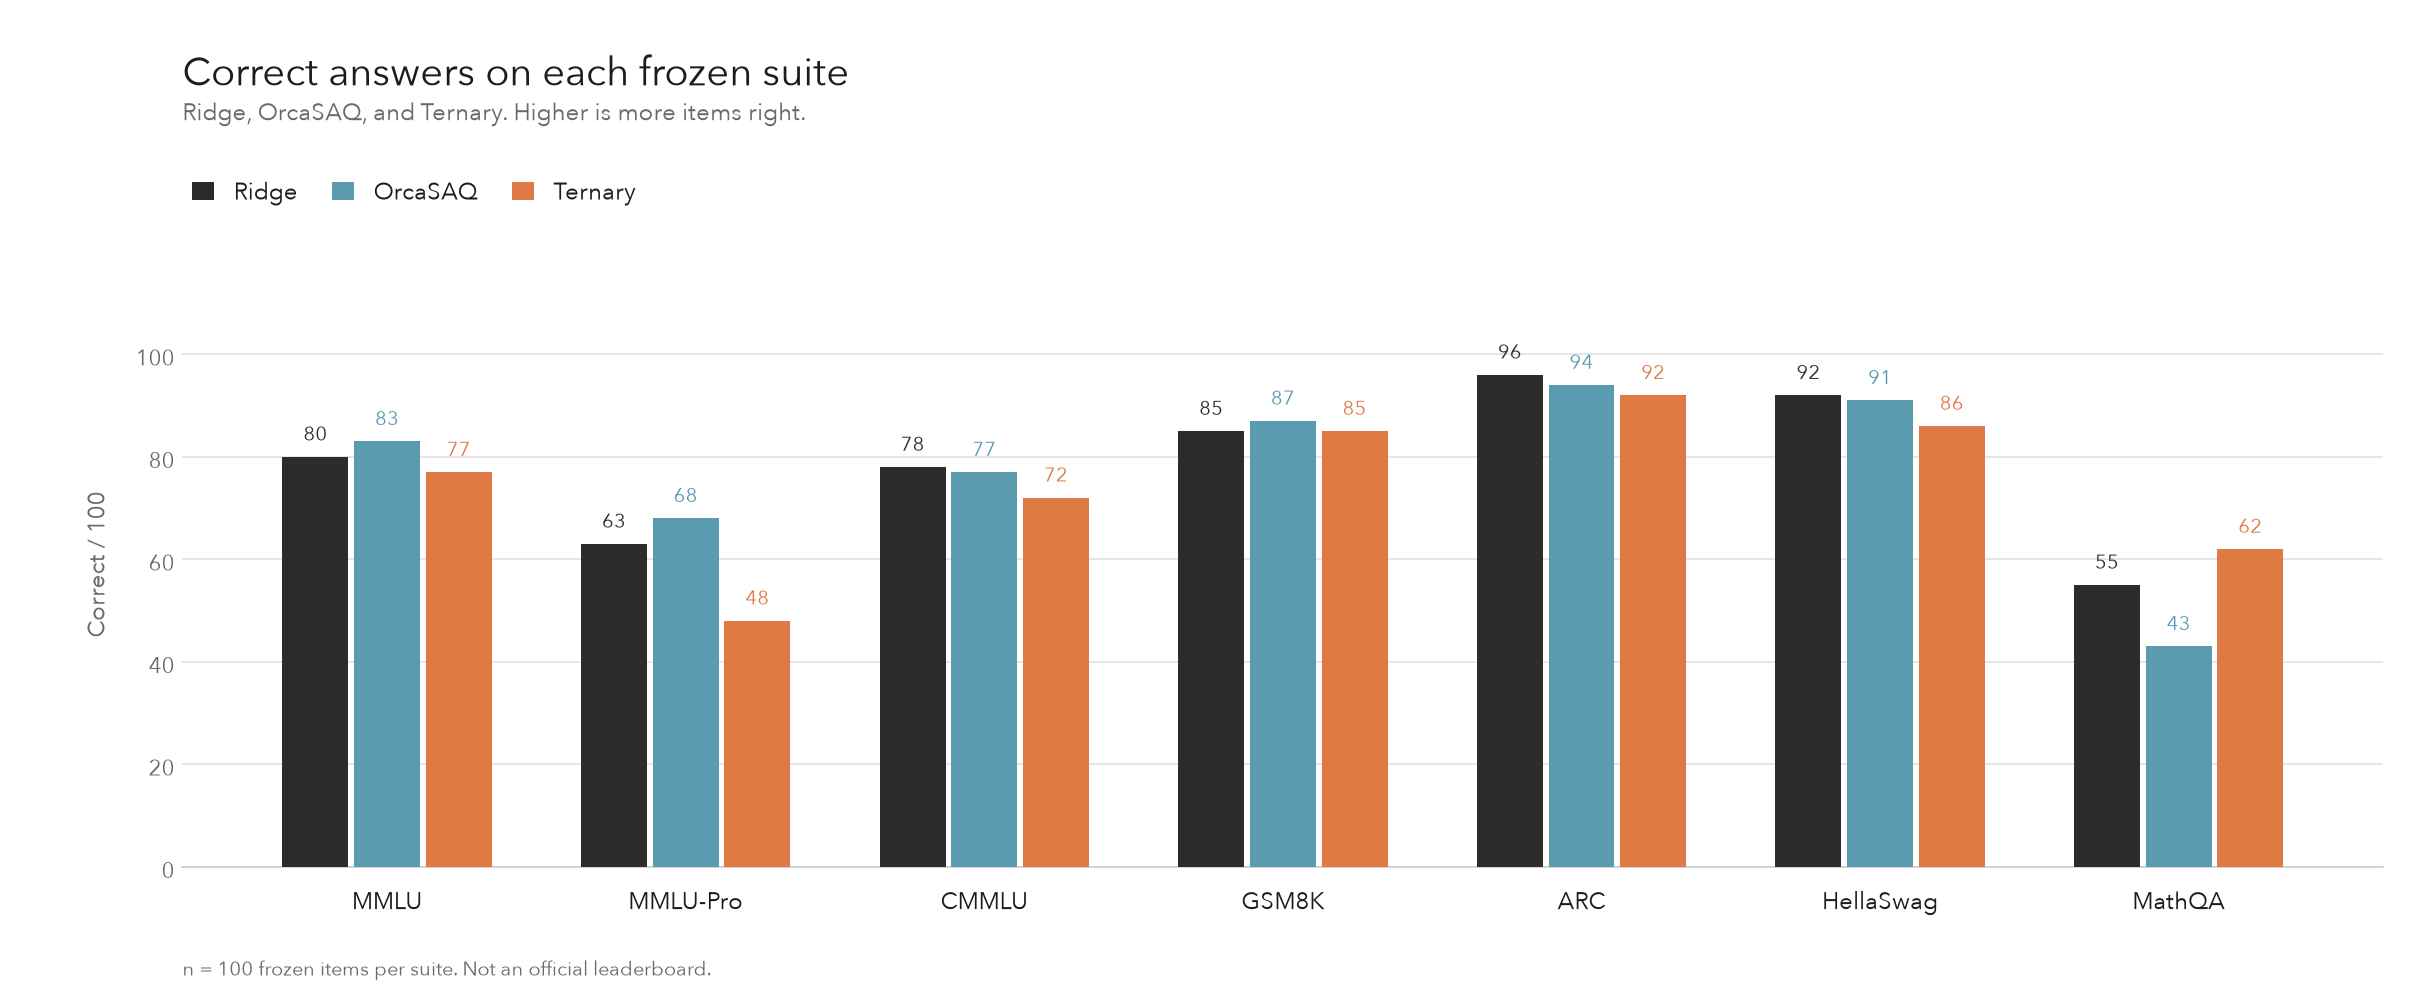
MMLU-Pro 是洞。Ternary 48,Ridge 63,OrcaSAQ 68。對 Ridge 少 15 題,對 OrcaSAQ 少 20 題。不過這 15 題不能整段算成「模型比較不會」。Ternary 在這 100 題裡有 37 題碰到 512 token 上限,其中 34 題未過。Ridge 在這套的完成 token 平均是 2,上限次數是 0。OrcaSAQ 平均 27.5 個完成 token,上限 5 題。長篇解釋把額度吃掉之後,字母還沒被抽到,裁判就會記失敗。本輪沒有把上限提高到 512 以上再跑一次,所以不能估計那 34 題若寫完會對幾題。能說的是:這套的準確率落差,和輸出長度、和 512 的天花板,纏在一起。
MathQA 反過來。Ternary 62,Ridge 55,OrcaSAQ 43。Ternary 比 Ridge 多 7 題,比 OrcaSAQ 多 19 題。Ternary 在這套有 41 題碰到上限,其中 34 題未過、7 題仍過。Ridge 也有 20 題碰到上限。兩邊都被天花板切過,Ternary 切得更兇,總分仍較高。OrcaSAQ 的 MathQA 平均只有 109 個完成 token,上限 16 題。它寫得比較短,錯得比較多。這個落差比較不像是被 512 切出來的。
其餘套題的差距小得多。GSM8K 是 85、87、85,Ternary 與 Ridge 打平,OrcaSAQ 多 2 題。ARC-Challenge 是 96、94、92,三臂都在 92 以上。HellaSwag 是 92、91、86,Ternary 少 6 題,不是崩掉。MMLU 是 80、83、77。CMMLU 是 78、77、72。若只看總分,會以為 Ternary 全面薄一層。分項不是這樣。
速度要看牆鐘,不要只看 tok/s
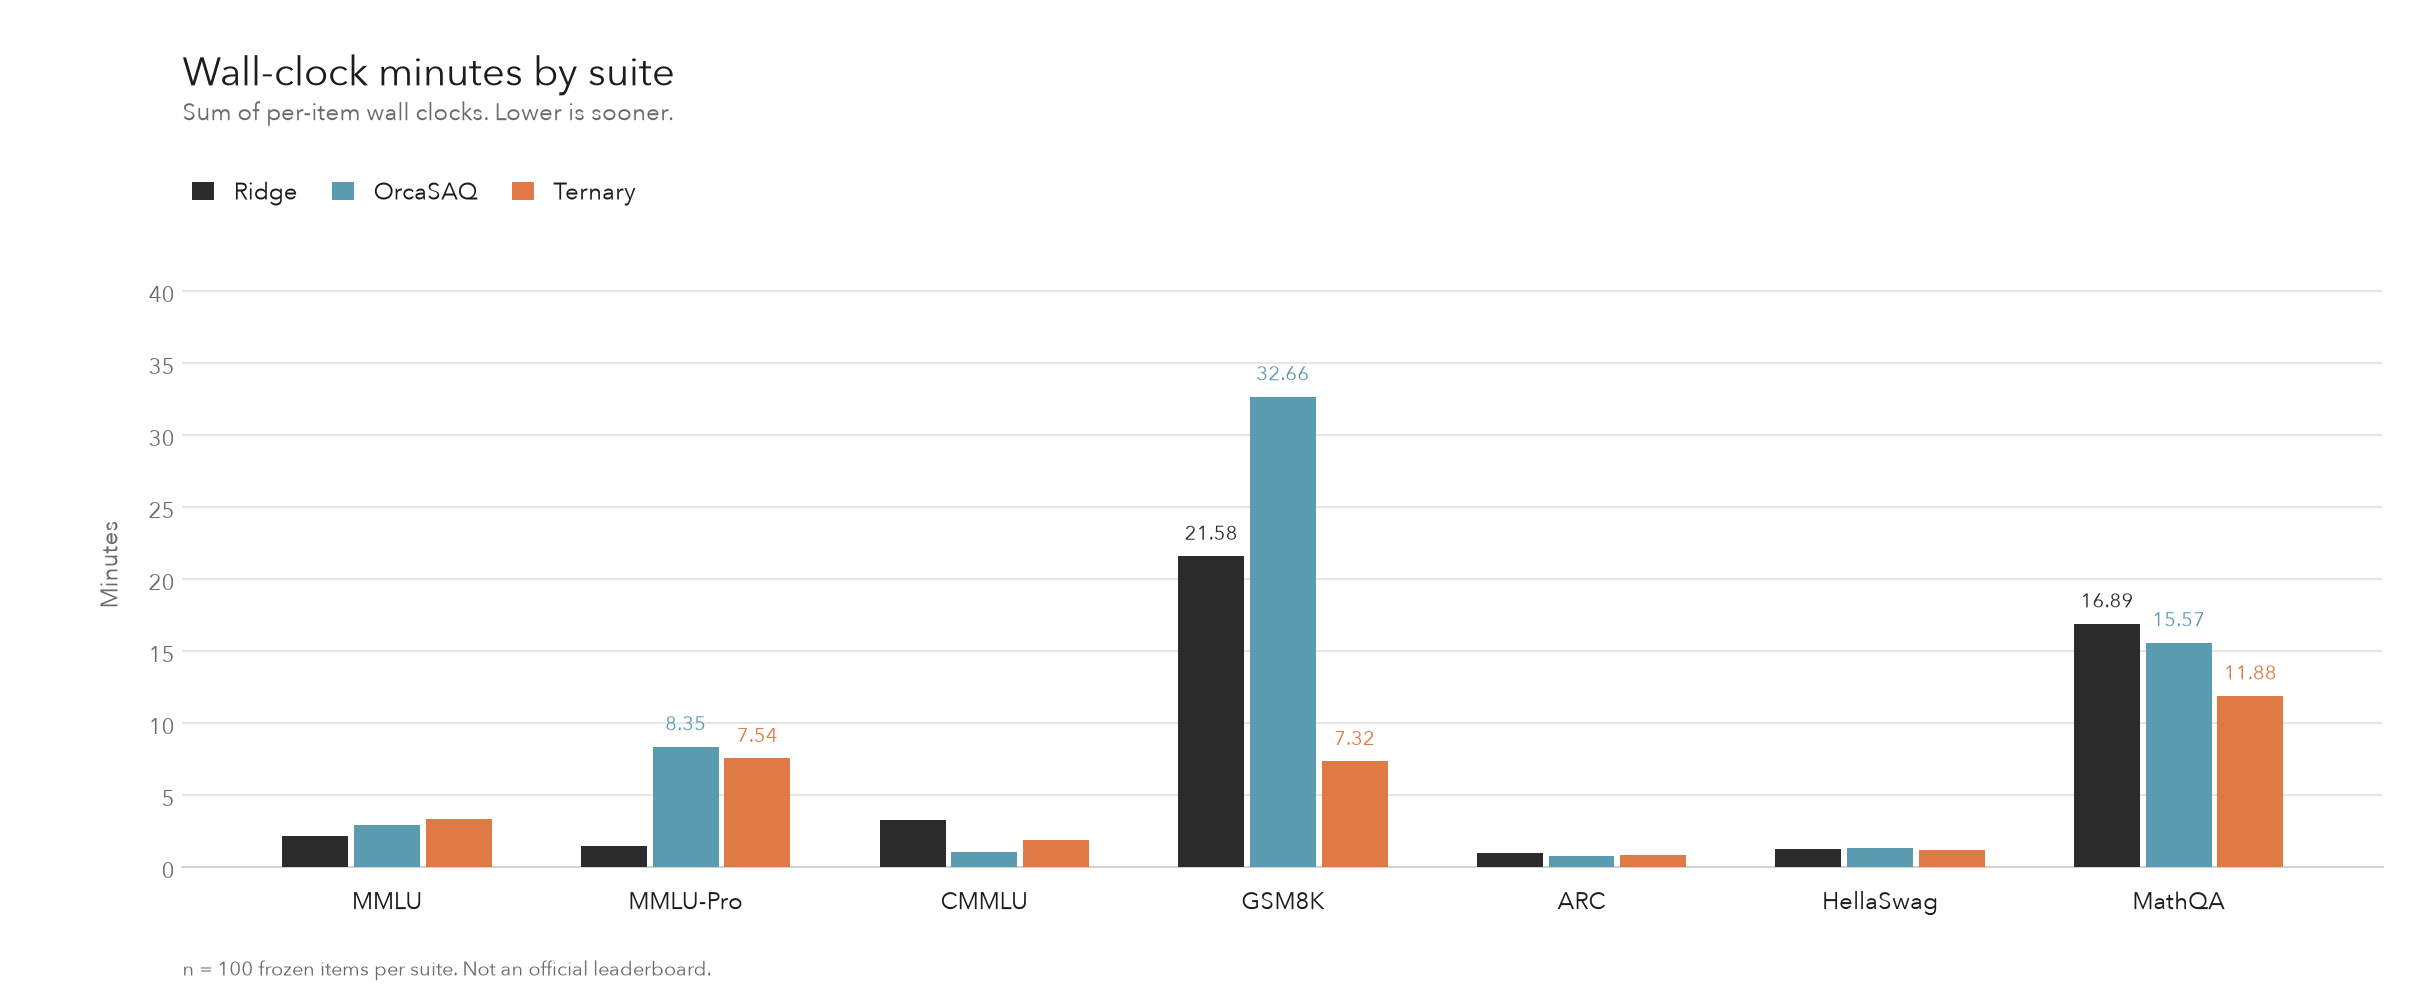
Ternary 跑完 700 題用 34.01 分鐘,Ridge 47.55 分鐘,OrcaSAQ 62.59 分鐘。
你為什麼不能只看 tok/s?
完成 token 除以牆鐘,Ternary 是 46.74 tok/s,Ridge 是 17.45,OrcaSAQ 是 10.85。看起來像 2.68倍 與 4.31倍。牆鐘只快到 1.40倍 與 1.84 倍:Ridge 的總時間是 Ternary 的 1.40 倍,OrcaSAQ 是 1.84 倍。Ternary 比 Ridge 少用 28.5% 的牆鐘,比 OrcaSAQ 少用 45.7%。好比只看時速表、不看抵達時間。tok/s 量的是吐字速率,牆鐘量的是這 700 題何時做完。
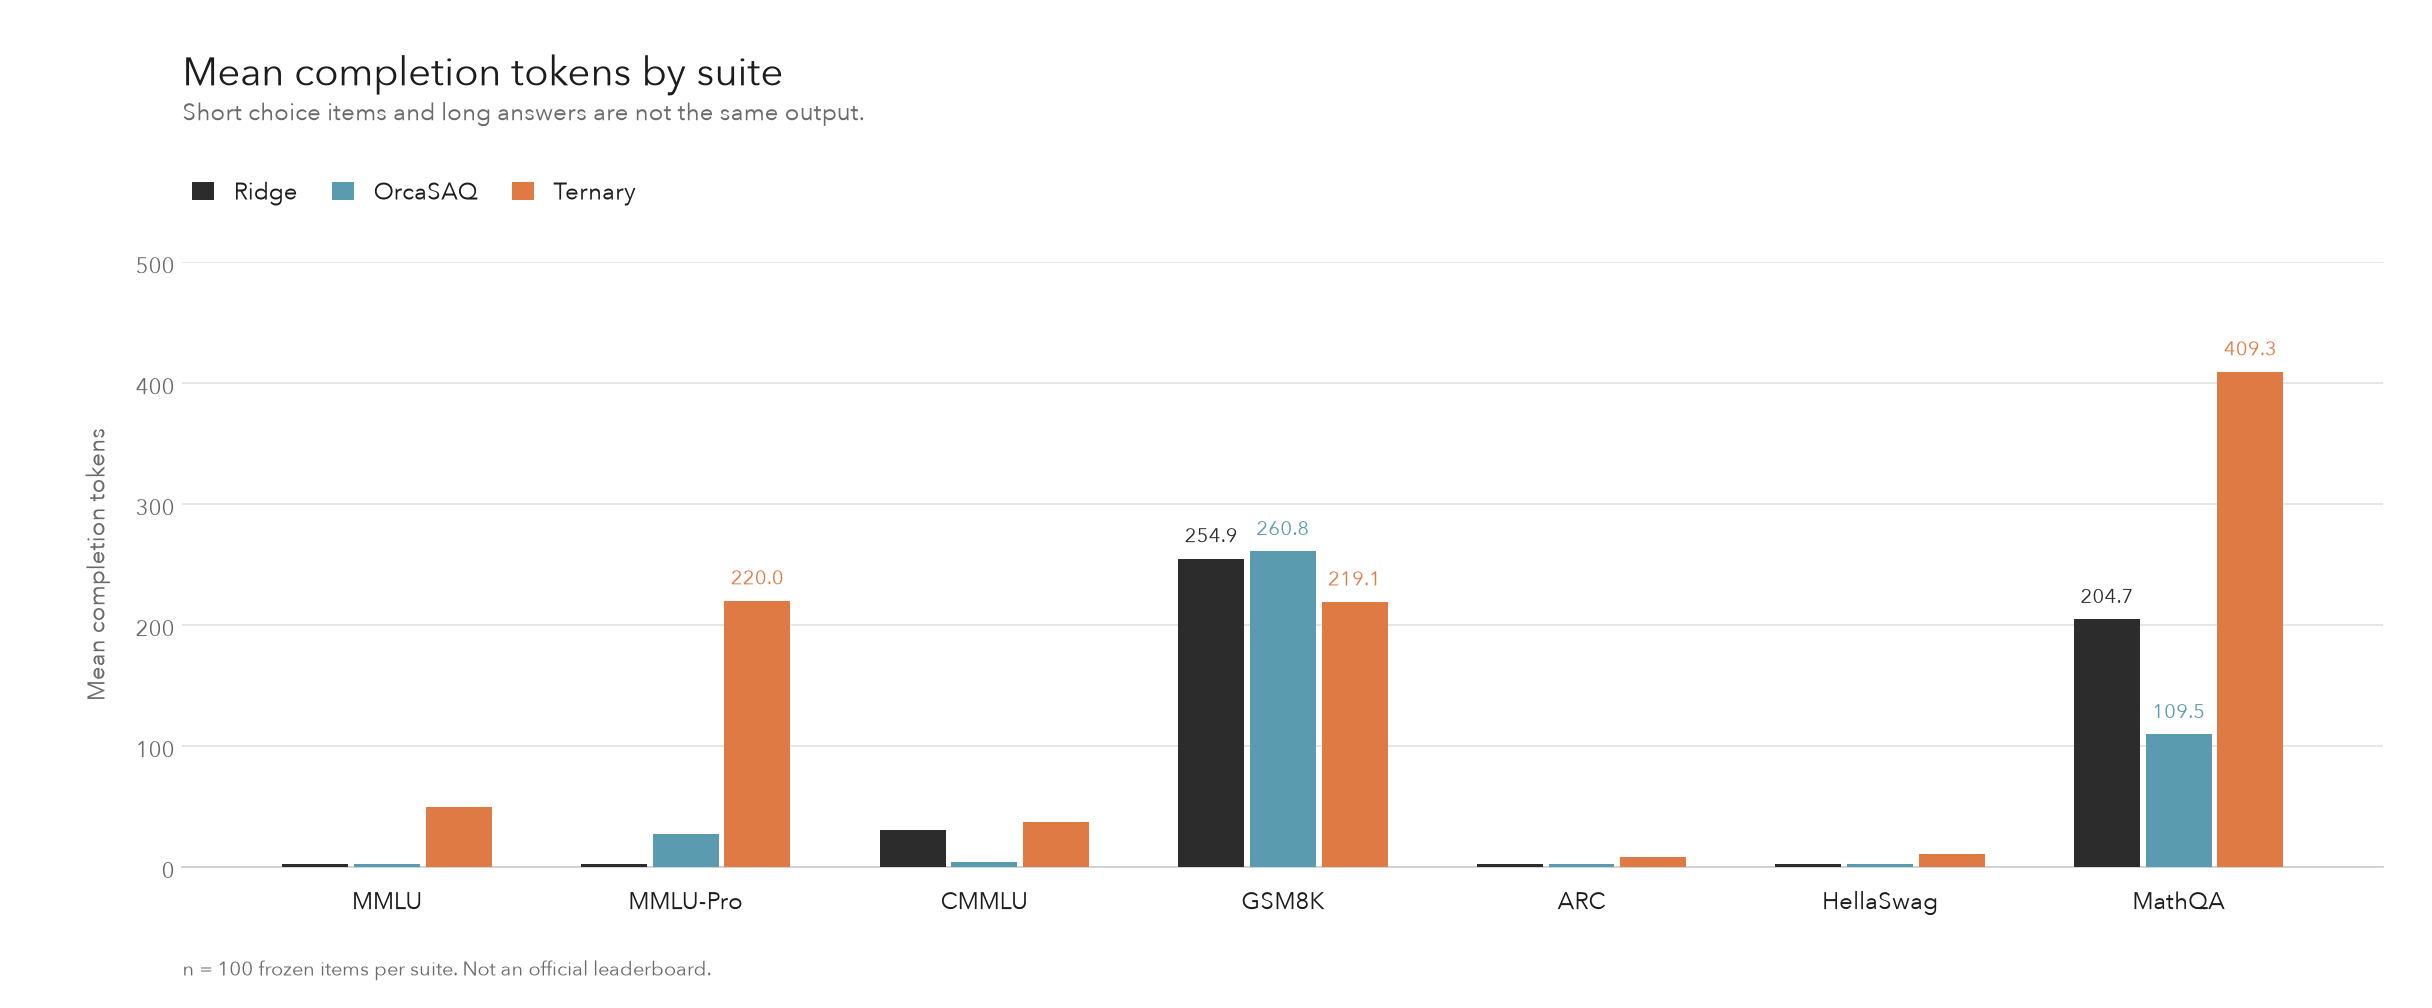
原因在字數。Ternary 一共寫了 95,395 個完成 token,平均 136.3。Ridge 是 49,792,平均 71.1。OrcaSAQ 是 40,742,平均 58.2。字數多,tok/s 的分子就大。多寫出來的字會在牆鐘上堆積,可是堆積的方式不是每題都一樣。短選擇題上,Ridge 和 OrcaSAQ 經常只吐 2 個 token,也就是一個字母。Ternary 在 MMLU 平均寫 49.3 個,在 MMLU-Pro 平均寫 220 個。同一道選擇題,一個交字母,一個交一段解釋。速率表會把後者說得飛快,抵達時間卻不一定。
| 套題 | Ridge | OrcaSAQ | Ternary |
|---|---|---|---|
| MMLU | 2.13 | 2.94 | 3.35 |
| MMLU-Pro | 1.43 | 8.35 | 7.54 |
| CMMLU | 3.27 | 1.07 | 1.87 |
| GSM8K | 21.58 | 32.66 | 7.32 |
| ARC-Challenge | 0.98 | 0.73 | 0.85 |
| HellaSwag | 1.27 | 1.28 | 1.20 |
| MathQA | 16.89 | 15.57 | 11.88 |
| 合計 | 47.55 | 62.59 | 34.01 |
合計是原始秒數加總後再換成分鐘。上表各列若先四捨五入再相加,OrcaSAQ 會差 0.01 分鐘,以合計欄為準。
總時間的優勢不是七套均勻發下來的。GSM8K 上,三臂的完成 token 平均是 255、261、219,長度接近。牆鐘卻是 21.58、32.66、7.32 分鐘。Ridge 的這套時間是 Ternary 的 2.95 倍。這裡的速度差,比較像解碼本身,不是因為 Ternary 少寫了字。MathQA 上,Ternary 平均寫 409 個 token,已經靠近 512 的天花板,牆鐘仍是 11.88 分鐘,短於 Ridge 的 16.89 與 OrcaSAQ 的 15.57,而且答對更多。短選擇題則不是這個故事。ARC-Challenge 與 HellaSwag 三臂都在 1.3 分鐘以內。CMMLU 最快的是 OrcaSAQ,1.07 分鐘。MMLU-Pro 最快的是 Ridge,1.43 分鐘。Ternary 在這套用了 7.54 分鐘,比 Ridge 慢,又比 Ridge 少對 15 題。
所以「Ternary 比較快」只在 700 題的加總上成立。它快在 GSM8K 和 MathQA 這兩段長題。它沒有在每一套選擇題上都比較快,也沒有在最難的選擇題上又快又準。
分項會改你的選擇
總分落後的那套,在 MathQA 反而領先,在 MMLU-Pro 則掉最多。
若你的工作比較像這份凍結清單裡的 GSM8K,Ternary 用約三分之一的牆鐘,答對題數與 Ridge 相同,只比 OrcaSAQ 少 2 題。若工作比較像 MathQA,Ternary 又快又多對,但有 41 題被 512 切到,其中 34 題未過。把上限留在 512,等於接受這批被切掉的失敗。若工作比較像 MMLU-Pro 這種選項更擠、又被要求只交字母的題,Ridge 用 1.43 分鐘對 63 題,OrcaSAQ 用 8.35 分鐘對 68 題,Ternary 用 7.54 分鐘對 48 題。這裡速度和準確率沒有一起站到 Ternary 那邊。
OrcaSAQ 的總分只比 Ridge 少 6 題,可是 MathQA 少 12 題,MMLU-Pro 多 5 題。它不是 Ridge 的慢速複製品。總分接近,分項會搬位置。
什麼時候該用哪一套
契約若是客觀抽答,選 Ridge;契約若是同題牆鐘,選 Ternary。
契約若是「這份凍結清單上的字母與數值抽答」,Ridge 的 549 題是這三臂裡的高點。OrcaSAQ 只少 6 題,除非 MathQA 佔你的工作很大一塊,否則總分幾乎黏在一起。契約若是「同一張 4060 Ti、同一份 700 題、同樣關掉 thinking,何時做完」,Ternary 的 34.01 分鐘是高點,代價是少 27 題,而且代價集中在 MMLU-Pro,又和 512 的天花板纏在一起。
不該用這份數字做的事也很具體。不要用它決定寫作品味。不要用它決定工具迴圈能不能接上。不要把三套 runtime 同時塞進 16GB,讓它們互相用掉顯示記憶體。不要把廠商的 thinking 模式平均分,減去這次溫度 0 的抽答率。不要把 100 題切片寫成完整 MMLU 或完整 GSM8K。也不要因為 tok/s 看起來是 2.68 倍,就以為每題都會快 2.68 倍。
這份數字不能外推到哪裡
它不是寫作品味、工具迴圈,也不是廠商 thinking 模式的官方榜。
研究範圍是一台 Windows 工作站、一張 RTX 4060 Ti 16GB、2026-09-28 這三輪分時服務。每套 100 題,不是完整基準,也沒有在這篇文章裡重做信賴區間。6 題的總分差很薄。27 題比較厚,可是其中 MMLU-Pro 的 15 題和輸出上限纏在一起,不能單獨寫成能力差。Ridge 與 Ternary 的權重檔,本輪都沒有重算雜湊。裁判沿用結果檔裡的 passed,沒有另寫一版抽取器來交叉驗證。context 長度沒有記在這次可以公開的協定欄位裡。溫度 0、關閉 thinking、512 token,是這次的部署契約,不是這三個模型卡的建議取樣。
然而,在這個契約裡面,排序是穩的:逐題重算與結果檔表頭一致,三臂題目雜湊一致,請求錯誤數是 0。準確率冠軍是 Ridge。速度冠軍是 Ternary。兩者不是同一套部署。