想像一下:你只有 16GB 顯示記憶體,就像口袋電量只剩半格,卻還想把 27B 級日常工作留在本機。我要速度、長文、工具呼叫三件都過關,才敢動 default。
先講結論給趕時間的人
能力打平、長文與工具都綠,才把 default 指到 Ternary。
短題能力打平、長文公平通道兩邊能過、工具迴圈全綠後,我才把 stable 別名 default 指過去;速度約 1.5倍 是加分,不是唯一理由。這不是下載完就升格的故事。
這顆模型到底是什麼
主錨是三值 GGUF,不是 stock Ollama 熱插拔 tag。
它掛在 Hugging Face 的 prism-ml/Ternary-Bonsai-2-27B-gguf,從 Qwen3.8-27B 衍生,權重走三值 g128。官方兩種打包:PTQ1_0 約 5.95 GB、PQ2_0 約 7.21 GB。我實測選 PQ2_0,跑 Prism 維護的 llama.cpp server。權重會直接吃掉 VRAM,不會先膨脹回 FP16 再算。
你知道嗎?很多「2-bit」標籤的真實平均位元更肥。Bonsai 強調端到端三值覆蓋,這才是它跟常規低位元族的差。如同把行李箱壓到能登機,卻還要衣服能穿出門。
對打怎麼才算公平
同機對打、關 thinking、VRAM 互斥,才叫公平。
對照臂是同機台 Qwen3.8 密集日常模(Ollama 路徑)。兩邊溫度與長度對齊。測 Ternary 就讓 Ollama 主載罷工,反之亦然。好比實驗室只開一台離心機,不要兩台同時搶電管著同一條線路。
層級 0 到 1:短題與功能閘
煙測上 Ternary 約 33 tok/s,對照約 22 tok/s。功能閘用 JSON 契約、修 bug、繁中技術文、極端字數約束共 7 題:兩邊 pass/fail 圖案一致,4 過 3 掛,掛的是同一類邊界。我像改考卷一樣對答案,曲線重疊,只是其中一位交卷比較快。
層級 2:長文針刺會不會裝死
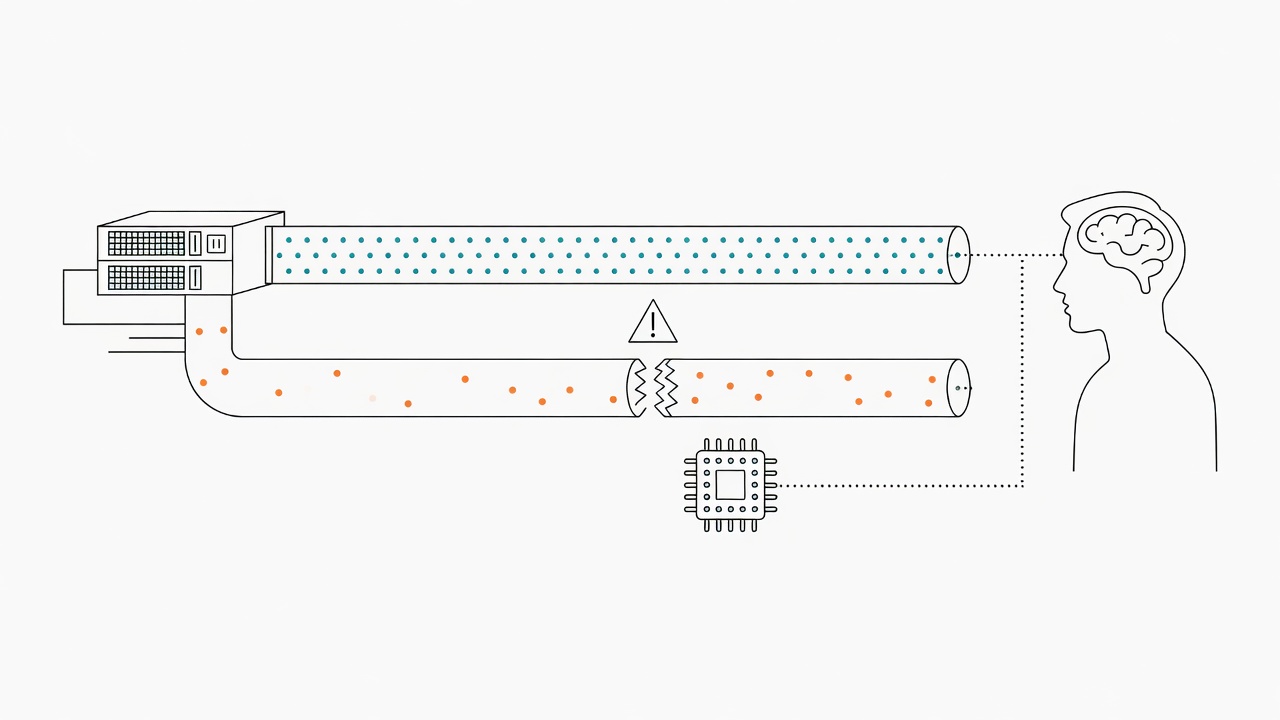
隱藏針刺 12k/28k/48k 字元,兩邊全過;Ternary 牆鐘常快 1.4 到 2.2倍。再壓 80k/120k,本機公平通道仍 pass。公開反向代理在 120k 對照臂回 HTTP 524:那是通道首字節逾時,維修的是線路,不是把模型砸爛判死刑。資料堆積在代理外緣時,模型本人可能還醒著。
層級任務形狀:工具迴圈有沒有接上
經 OpenAI 相容代理,晨報草稿、協議卡、繁中潤稿、bash 工具、多輪 write、嚴格 JSON 共 9 題全綠。你為什麼還要這層?因為短題打平只證明會考試,不證明日常 agent 水管接得上。我們若跳過工具層,升 default 只是自嗨。
什麼時候該試,什麼時候別試
有 16GB CUDA 與維護 runtime 的意願再試;否則別硬上。
該試:要穩定長上下文與 OpenAI 形 API、能用 stable 別名切 backend。這時 Ternary 像把重活從雲端吃掉一截,本機吞吐用掉得更乾脆。
別試:指望 stock Ollama 一鍵 create;要 Ollama 與 Ternary 同卡常駐;把公開代理 524 寫成模型死刑;把敏感資料送進這台工作站。權重格式變懶或 kernel 對不上時,檔案下載完整也會逃脫不了 create 失敗。
定案日期與研究限制
2026-09-19 pin default;範圍是單卡多層閘,不是全網榜。
當日起客戶端一律 pin default,backend 指到 Ternary;Ollama 密集模退成可切備援。不過研究範圍仍是單卡 16GB、單日多層閘門。限制含 VRAM 互斥、自訂 kernel 依賴、長程多檔 agent 尚未當唯一分隔線。值得注意:公平本機路徑上,對照臂在某些 120k 針刺牆鐘甚至更快,所以「全面比較快」不能當口號。我把方法論寫清楚,是要你能重跑,不是要你盲跟。