33 秒。我在 Mac 上按下 Enter,倒了杯水回來,模型已經學會輸出我要的 JSON schema 了。
不是雲端 GPU,不是租 A100,也不是那種「理論上可以但實際上沒人做」的概念驗證。就是一台 M4 Pro 的 MacBook Pro,跑完 60 步 LoRA 訓練,loss 從 1.06 降到 0.17,記憶體峰值不到 7GB。於是微調完的模型直接吐出乾淨的單行 JSON,不再包 markdown 圍欄,不再美化縮排,就是我要的格式。
這篇文章記錄整個過程:為什麼選 Gemma-4 E4B、踩了什麼坑、怎麼繞過去、結果長什麼樣。如果你也在 Mac 上跑本地模型,想讓它「越用越合手」,這條路已經被驗證過了。
為什麼選 Gemma-4 E4B
故事要從 oMLX 跑分說起。
我手邊常駐四顆本地模型,用 oMLX 社群跑分做了一輪效能測試。結果很明確:
| 模型 | Prefill (tok/s) | 生成 (tok/s) | 記憶體占用 |
|---|---|---|---|
| gemma-4-e2b 4bit | 2,090 | 133.7 | ~3.5GB |
| gemma-4-e4b 4bit | 1,117 | ~90 | ~6.8GB |
| Qwen3.6-35B-A3B-UD 4bit | 777 | 69.9 | ~20GB |
| qwen3-4b | 721 | — | ~2.5GB |
Gemma-4 E4B 在同級距裡推理速度明顯快過 qwen3-4b,而且長 context(到 64K)效能衰減平緩。更重要的是,它只吃 6.8GB,所以在 48GB 的機器上做 LoRA 訓練綽綽有餘。
但有件事我一開始沒注意到。
你以為它是文字模型,其實它是 VLM
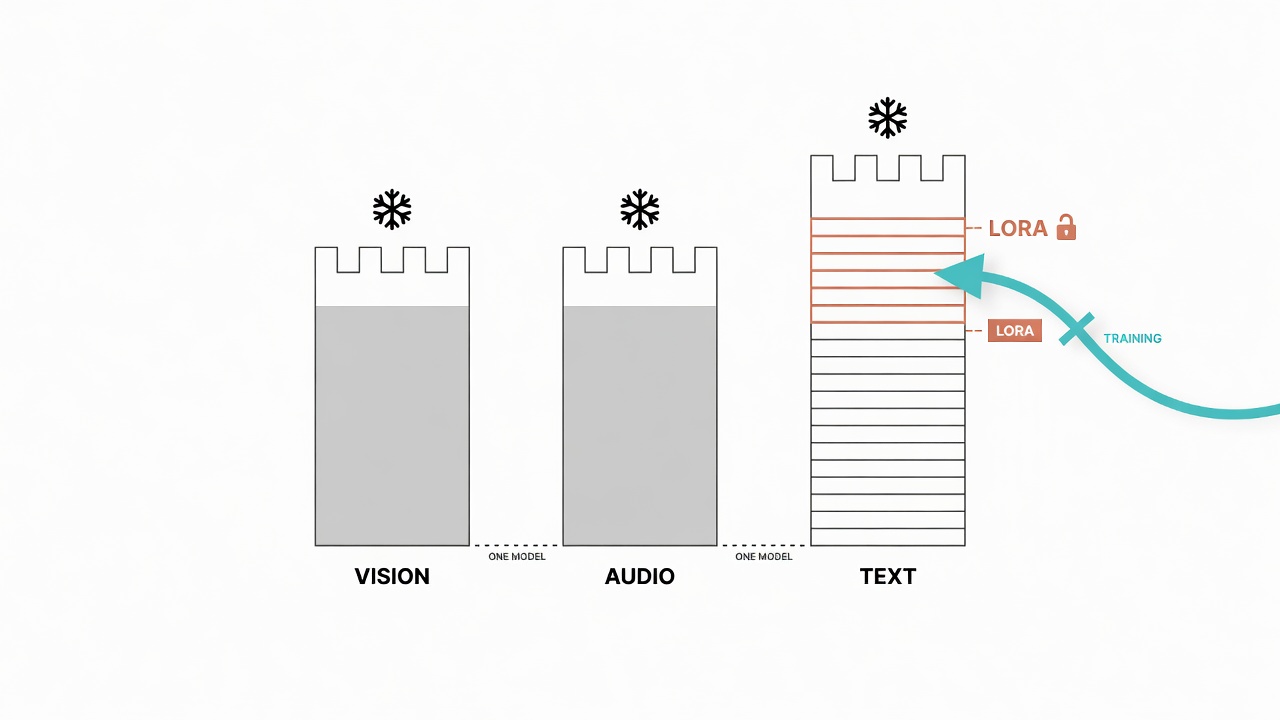
翻開 Gemma-4 E4B 的 config.json,赫然發現 ForConditionalGeneration、vision_config、audio_config。這不是純文字語言模型,它是一顆 omni 多模態模型,同時有 vision tower、audio tower 和 text tower。
更令人意外的是,我的主力模型 Qwen3.6-35B-A3B 也是 VLM。本地這四顆模型,沒有一顆是純文字 causal LM。
這代表什麼?代表你不能用 mlx_lm.lora 那條純文字微調路徑。既然是 VLM,就得走 mlx-vlm 的載入流程。但我要做的是純文字任務(NER 實體萃取),所以策略很簡單:凍結 vision tower 和 audio tower,只練 text tower 裡的語言層。
踩坑:mlx 0.31.2 的 KV-sharing 回歸
環境準備完畢。Python 3.12 虛擬環境、mlx-tune 0.6.0、mlx 0.31.2、mlx-vlm 0.6.3,全都是 PyPI 上的最新版。下載 lmstudio-community 的 gemma-4-E4B-it-MLX-4bit(flat 格式,6.8GB),準備開練。
結果一載入就炸了:
ValueError: Received 126 parameters not in model:
  layers.*.self_attn.k_norm
  layers.*.self_attn.k_proj
  layers.*.self_attn.v_proj
換成 e2b 試試?同樣的錯,只是數字變成 140。Gemma-4 的 e 系列在目前的 mlx 生態裡全軍覆沒。
根因
追查之後發現,這是 mlx 0.31.1 升到 0.31.2 時引入的回歸(mlx-lm issue #1242,2026 年 5 月開,截至本文撰寫仍未修復)。
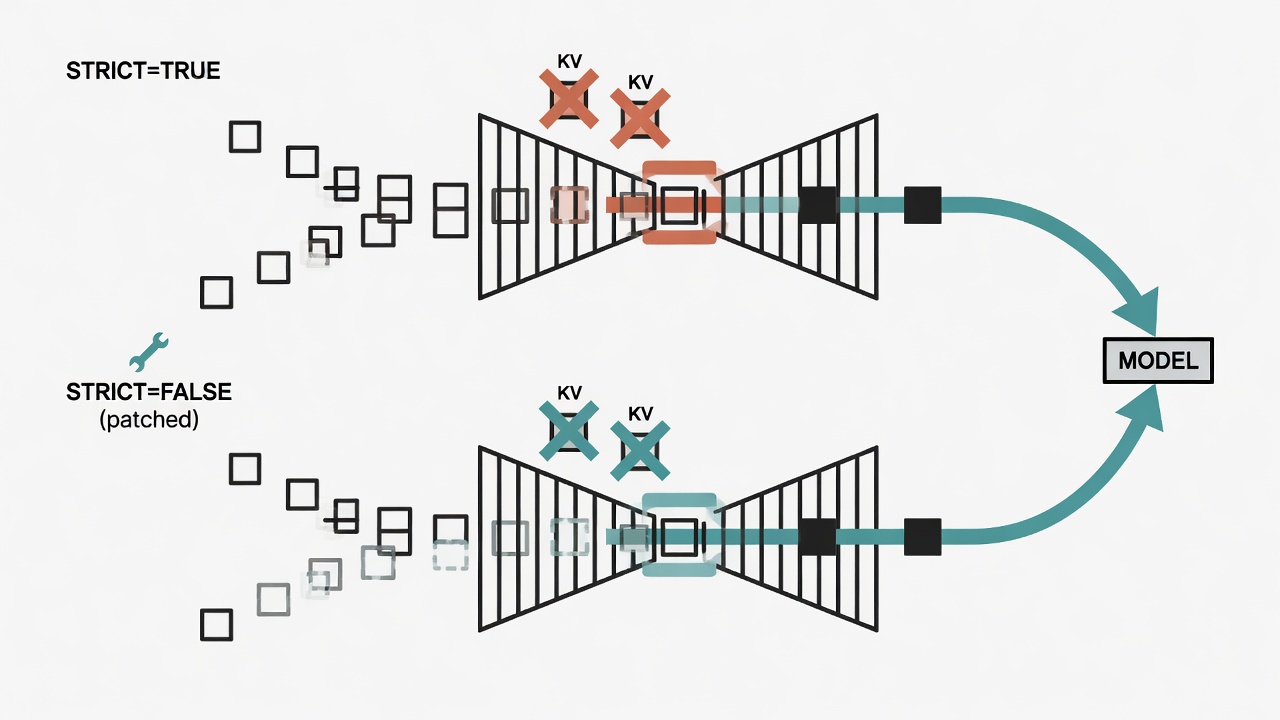
Gemma-4 的架構用了 KV-sharing 機制:部分 attention 層共用 K/V 投影,量化匯出時會產生一批「round-trip 冗餘副本」。由於這些張量在推理時根本用不到,模型定義裡也沒有對應的參數名稱。mlx 0.31.1 會靜默忽略它們,0.31.2 開始嚴格檢查,strict=True 直接拒收。
為什麼「官方解法」都不管用
第一直覺是降版。但 mlx-vlm 和 mlx-lm 都 pin 了 mlx>=0.31.2,而且 PyPI 上 0.31.1 已經被移除。因此降版這條路被依賴鏈堵死了。
第二直覺是用 strict=False。mlx 的底層 nn.Module.load_weights() 確實有這個參數。但 mlx-vlm 在內部呼叫 load_weights 時沒有把 strict=False 往下傳,所以你在外層怎麼設都沒效果。
解法:monkeypatch
既然公開 API 走不通,那就直接 patch 底層。在訓練腳本最前面,對 mlx.nn.Module.load_weights 做 monkeypatch,強制把 strict 參數改成 False:
import mlx.nn as nn
_orig_load = nn.Module.load_weights

def _patched_load(self, file_or_weights, strict=False):
    return _orig_load(self, file_or_weights, strict=False)

nn.Module.load_weights = _patched_load
於是那些冗餘張量被靜默丟棄,模型照常載入。實測生成結果是連貫的繁體中文,架構完全正確。這個 workaround 的道理很單純:那批 K/V 張量本來就是多餘的副本,丟掉不影響推理。
訓練:45 筆資料、60 步、33 秒
載入問題解決之後,訓練本身反而簡單。
我的任務是六維 NER(命名實體辨識):給一段生醫文本,要求模型輸出包含六個維度的 JSON 物件。訓練資料用腳本產生,45 筆 train、5 筆 valid,格式是 ChatML 的 jsonl。
LoRA 超參數:
| 參數 | 值 |
|---|---|
| rank (r) | 16 |
| alpha | 16 |
| dropout | 0 |
| 目標模組 | q/k/v/o/gate/up/down_proj |
| batch size | 1 |
| gradient accumulation | 4 |
| learning rate | 2e-4 |
| max steps | 60 |
| max sequence length | 512 |
| train_on_completions | True |
跑完 60 步,耗時約 33 秒。loss 從 1.06 一路降到平均 0.17。記憶體峰值約 6.9GB,離 48GB 上限差得遠,所以完全不會影響其他應用程式。
Before vs After:格式服從的威力
微調的效果在 before/after 對比裡一目了然。
Before(base model,未微調):
模型收到 NER 指令後,確實辨識出了正確的實體,但輸出格式完全不合規:
- 用 ````json` 圍欄包裹
- 多行美化縮排
- 大小寫飄移(該小寫的寫成大寫)
- 需要額外後處理才能餵進下游管線
After(掛上 LoRA adapter):
- 直接吐出緊湊的單行 JSON
- 沒有圍欄,沒有多餘空白
- 大小寫正確
- 4 筆驗證句中,3 筆與 gold standard 完全一致
- 1 筆出現 HER2 的 protein/gene 分類混淆,屬於內容層的小錯,可以透過增加訓練資料修正
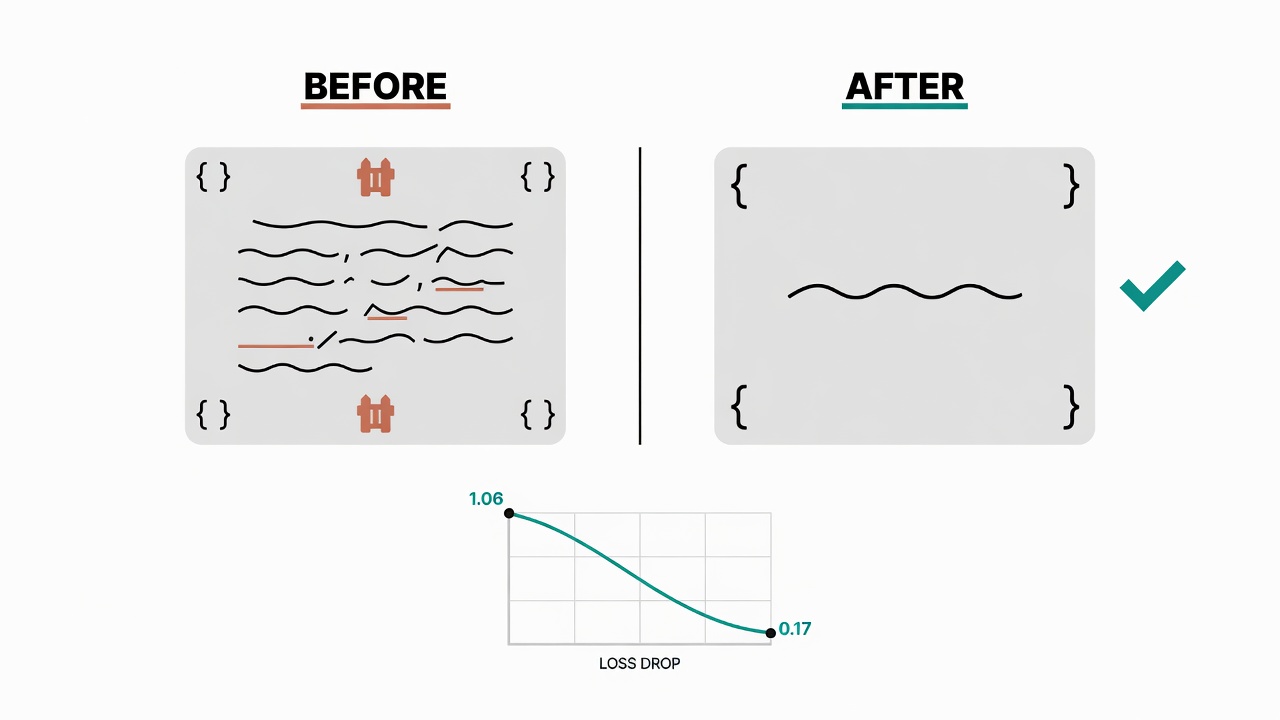
重點是:微調對「格式服從」和「風格貼合」的效果是立竿見影的。你不需要幾千筆資料、不需要訓練幾小時,45 筆範例、33 秒,模型就學會了你要的輸出結構。
至於內容正確度,那是資料品質和數量的問題,不是微調機制本身的限制。
「越用越合手」的迴圈
這次 MVP 驗證的核心命題不是「能不能微調」,而是「日常使用、定期微調、換 adapter」這個迴圈是否成立。
答案是成立的。而且成本低到令人意外。
這個迴圈長這樣:
- 日常使用:用本地模型處理日常任務(NER、分類、摘要、格式轉換)
- 收集樣本:把模型輸出好的結果標記起來,累積成訓練資料
- 定期重訓:每週或每月跑一次 LoRA,幾十秒到幾分鐘
- 換 adapter:新 adapter 上線,模型行為更貼合你的需求
- 回到第一步
這不是什麼線上學習或即時權重更新。那種做法在大型語言模型上不穩定,因此生產環境沒人用。實務上就是批次重訓加 adapter 熱抽換,簡單、可控、可回溯。
有幾件事要注意:
- 微調學的是「貼合」(格式、文風、領域術語),不是「提升智商」。模型的能力天花板不會因為微調而提高。
- 爛資料會導致災難性遺忘。一定要有品質校對和評測閘門。
- 事實知識交給 RAG 和記憶層處理,微調只負責風格和技能。
與 T15 的對照:Mac vs Windows
如果你讀過 T15(Windows 上的 QLoRA 微調),會發現兩條路線的取捨很不一樣:
| 面向 | T15 Windows QLoRA | T16 Mac LoRA |
|---|---|---|
| 硬體需求 | NVIDIA GPU(RTX 3060 以上) | Apple Silicon(M1 以上) |
| 框架 | Unsloth + PyTorch + CUDA | mlx-tune + MLX |
| 生態成熟度 | 主流,教學資源豐富 | 邊緣,需自己踩坑 |
| 微調速度 | 視 GPU 而定,通常較快 | 33 秒 / 60 步(E4B) |
| 記憶體管理 | VRAM 獨立,不影響系統 | 統一記憶體,需注意總量 |
| 最大痛點 | 驅動與 CUDA 版本衝突 | mlx 生態回歸與相容性 |
兩條路都能到達「越用越合手」的終點。差別在於 Windows/NVIDIA 那邊路平、車多、導航清楚;Mac/MLX 這邊是山路,偶爾要下車搬石頭,但風景不錯,而且你不需要另外買一張顯示卡。
後續展望
這次 MVP 驗證了最小迴圈,接下來有幾件事要做:
- 擴充訓練資料:修正 HER2 的 protein/gene 消歧問題,增加更多生醫領域的 NER 範例
- 接入日常採集管線:把日常使用中品質好的 prompt-response 對自動收集起來,作為下一輪微調的素材
- 雙模型分流:E4B 微調版負責高吞吐的預處理任務(NER、triage、標籤),35B 的 Qwen 繼續扛需要推理能力的重活
- 評估更多任務:除了 NER,還有繁中科普初稿、IRB 學術文體等任務等著試
33 秒能做的事比你想像的多。不需要租 GPU、不需要等雲端排隊、不需要把資料上傳到任何地方。你的 Mac 就是你的訓練機,你的日常使用就是你的訓練資料。模型會越用越合手,前提是你願意花 33 秒讓它學一次。